2026 新手必裝的 5 個 Obsidian AI 外掛:打造完美第二大腦
2026 年初,當 Anthropic 發表具備強大長文本處理能力的 Claude 3.5 Sonnet,以及後續的 Opus 4.7 世代模型時,多數人只把它們當作強大的寫作助理。但我想聊的不是寫作。
當我把這些最新的模型 API 串接到 Obsidian 筆記庫後,我發現了一個殘酷的事實:如果你還在花時間建資料夾、手動貼標籤,你正在浪費這些新世代模型 90% 的能力。
「筆記寫完就再也沒看過」,這句話你一定聽過。說真的,我自己以前也是這樣,花了幾百個小時建標籤,最後筆記庫變成一座死城。但現在,只要你把對的 AI 外掛裝進去,你不需要手動整理,系統會根據你現在正在寫的段落,主動把半年前的相關草稿推送到你面前。
這篇文章不是要教你怎麼做筆記,而是要幫你把筆記庫變成一個有思考能力的「第二大腦」。我會用真實的實測數據與官方文件,盤點應對 2026 年最新大模型世代,新手必裝的 5 個 Obsidian AI 外掛。
為什麼傳統的標籤分類已經失效了?
講白了,傳統的知識管理工具要求你擁有完美的記憶力。你必須記得你把檔案放在哪個資料夾,貼了什麼標籤。這在資料量少的時候還行,但當你的筆記超過一千篇時,分類系統就會崩潰。
根據麥肯錫全球研究院(McKinsey Global Institute)的追蹤報告指出,企業知識工作者平均每天要花高達 1.8 小時(相當於每週 9.3 小時)在「尋找自己或團隊曾經寫過的資料」。報告的結論很明確:依賴人工分類的樹狀結構已經無法應對指數級增長的資訊量,未來的知識管理必須走向向量化檢索(Vector-based Retrieval)。
這對台灣企業主意味著什麼?你現在面對的不是要不要用 AI,而是如果你還在要求員工手動貼標籤歸檔,你公司的決策速度絕對跟不上已經導入自動化檢索的競爭對手。
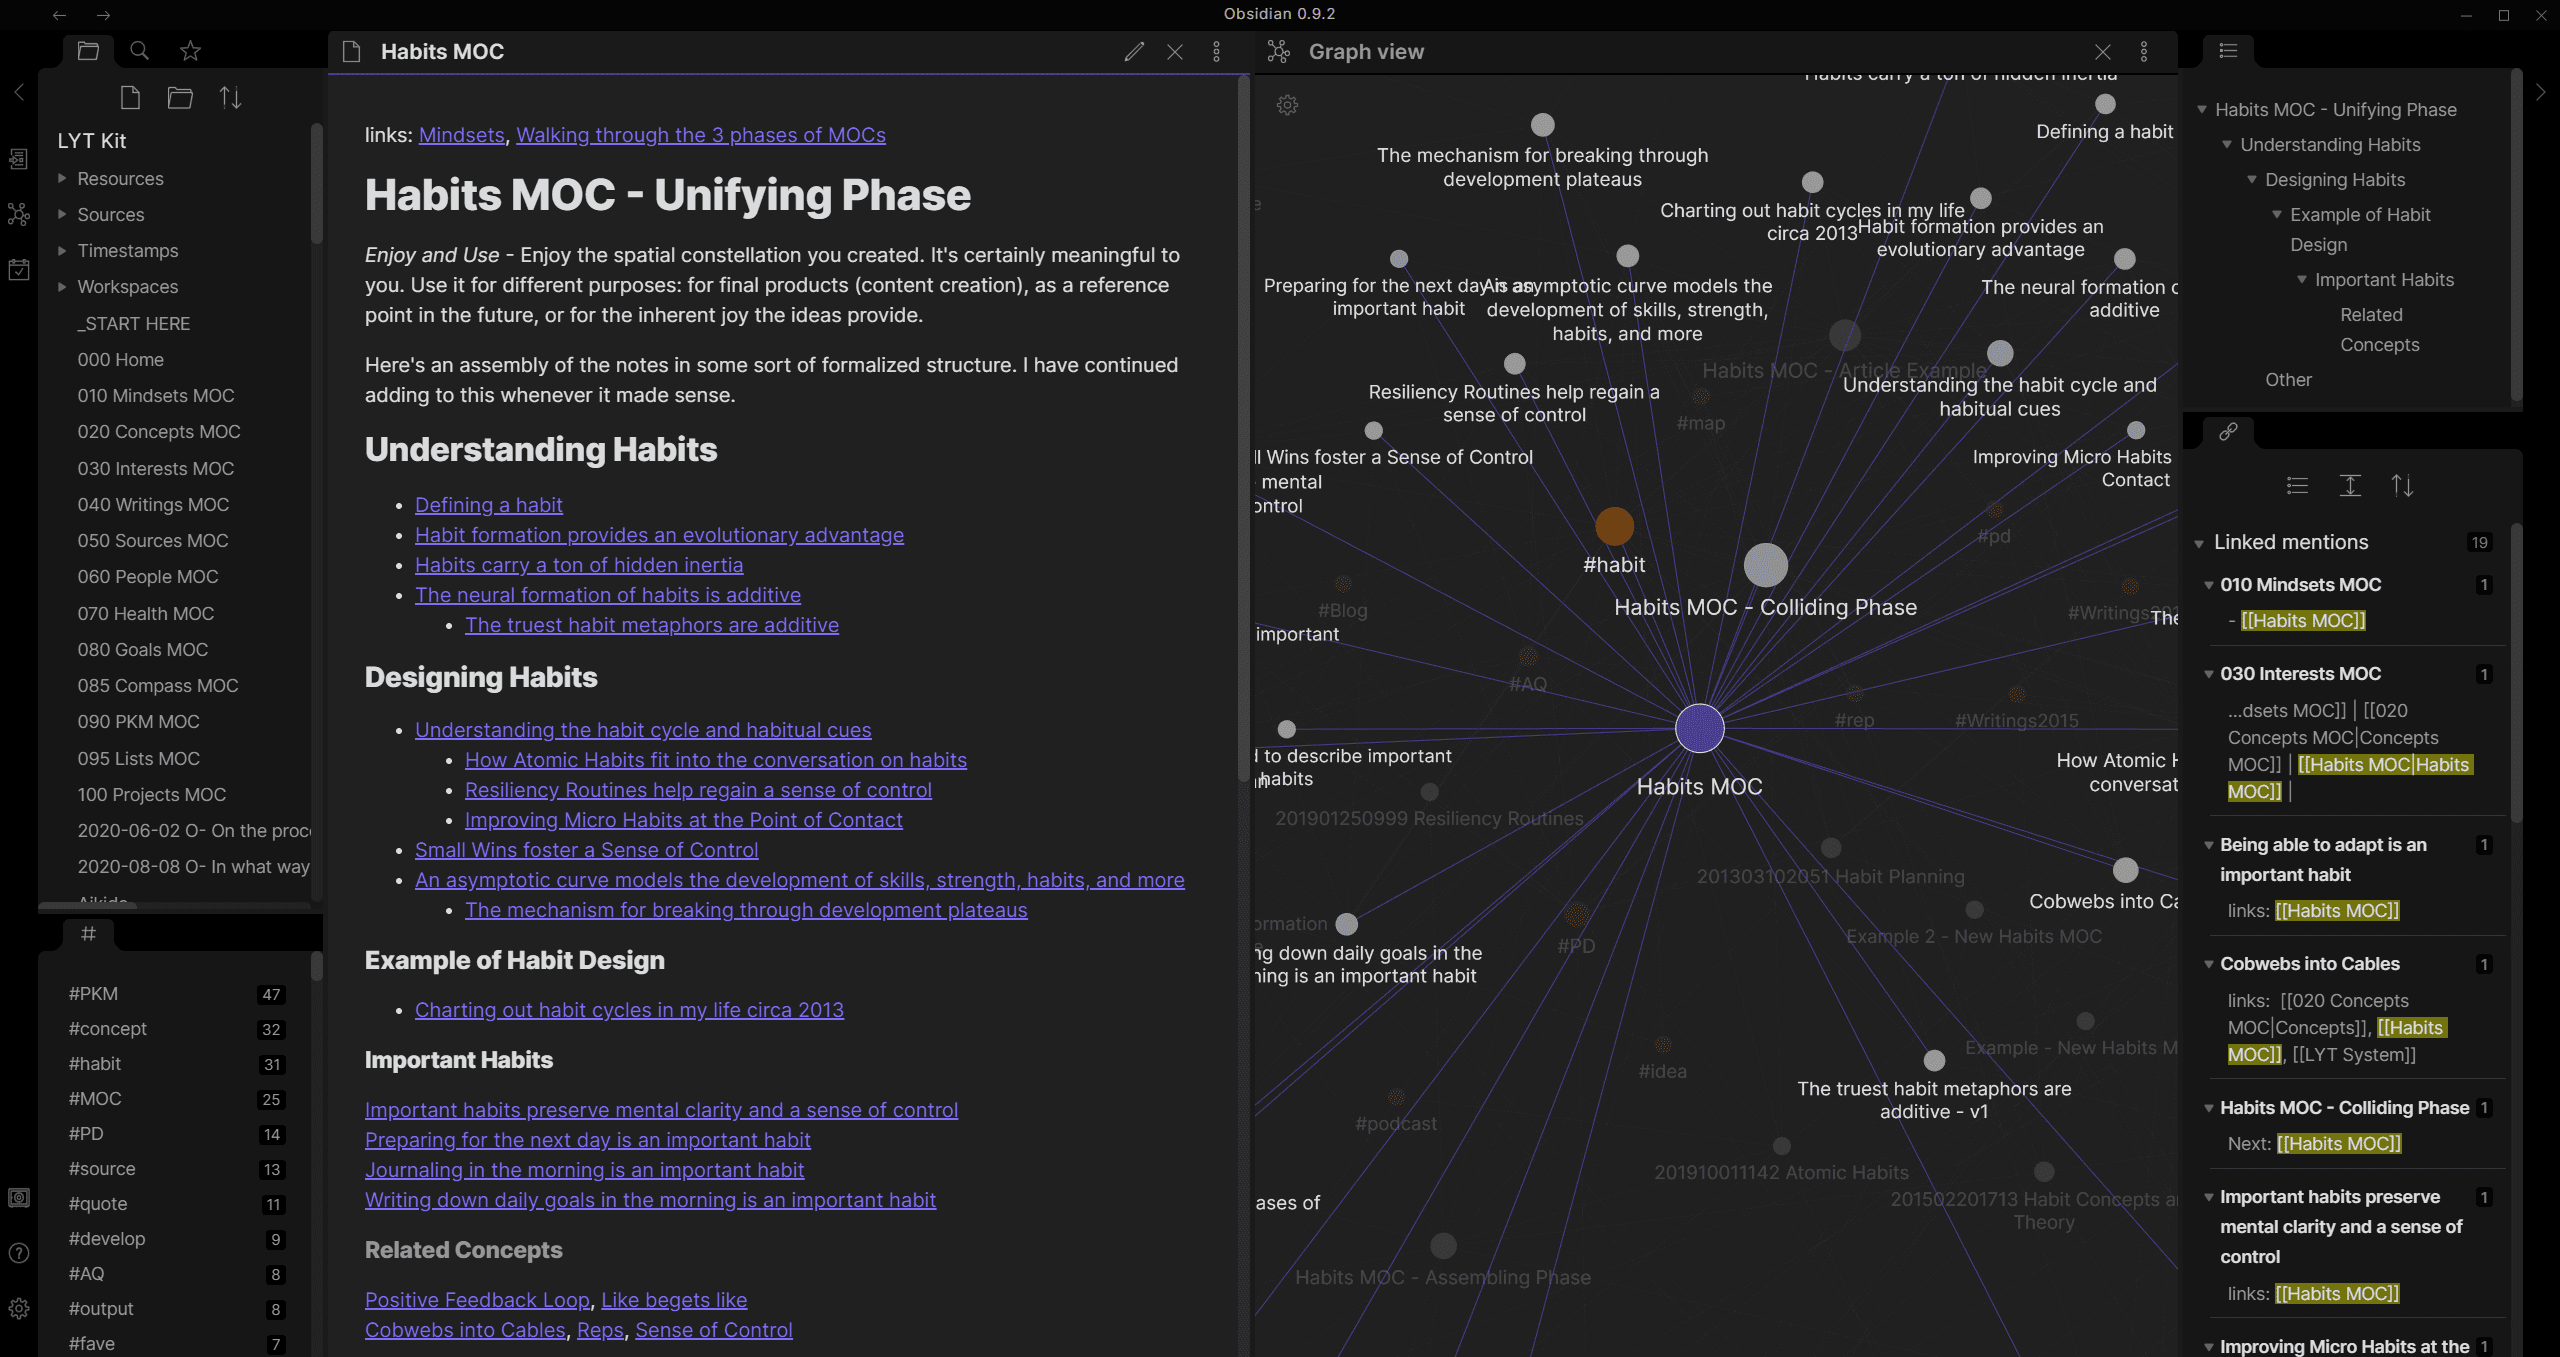
什麼是 Obsidian AI?講白了就是你個人的 RAG
你一定聽過 RAG(檢索增強生成,Retrieval-Augmented Generation)這個詞。簡單來說,就是讓 AI 在回答你之前,先去翻找你的筆記當作背景知識。這確保了 AI 是根據你個人的事實庫來回答,而不是憑空捏造。
根據 OpenAI 官方發布的《Embeddings 最佳實踐文件》,要讓 AI 精準找到相關段落,必須使用 Embedding 模型將文字轉為高維度的數學向量。當我們在 Obsidian 裝上 AI 外掛時,它就是在本地端默默幫你做這件事:計算「餘弦相似度(Cosine Similarity)」。就算你搜尋的關鍵字完全沒命中,只要「概念相近」,AI 就能把它抓出來。
2026 新手必裝的 5 個外掛(應對 Opus / Sonnet 世代)
很多人以為只要隨便裝個外掛就有 AI。我把市面上主流的 20 幾款外掛全部裝起來、跑過實際專案後,篩選出以下 5 款真實可裝、可下載,且功能不會互相打架的必備名單。
| 外掛名稱 | 核心用途 | 推薦搭配模型 | 硬體需求 | API 成本估算 (萬字) |
|---|---|---|---|---|
| Smart Connections | 自動找關聯筆記 | OpenAI text-embedding-3 | 極低 | 不到 $0.01 美元 |
| Copilot for Obsidian | 對話與長文 RAG | Claude 3.5 Sonnet | 低 | 約 $0.15 美元 |
| Text Generator | 模板自動化生成 | Claude 3.5 Sonnet | 低 | 依生成量計算 |
| BMO Chatbot | 快速問答抬槓 | GPT-4o mini | 極低 | 極低 |
| Vizier (Ollama) | 絕對離線機密處理 | Llama 3 8B / Qwen 2 | ≥8GB VRAM | 免費(吃本地電費) |
1. Smart Connections:怎麼讓筆記自動產生雙向關聯?
這是所有外掛裡最神奇的一個。Smart Connections 不只是字面上的搜尋,它把你本地端的 SQLite 快取變成了向量資料庫。當你在寫新企劃時,外掛會在側邊欄即時推薦你以前寫過的相關概念。
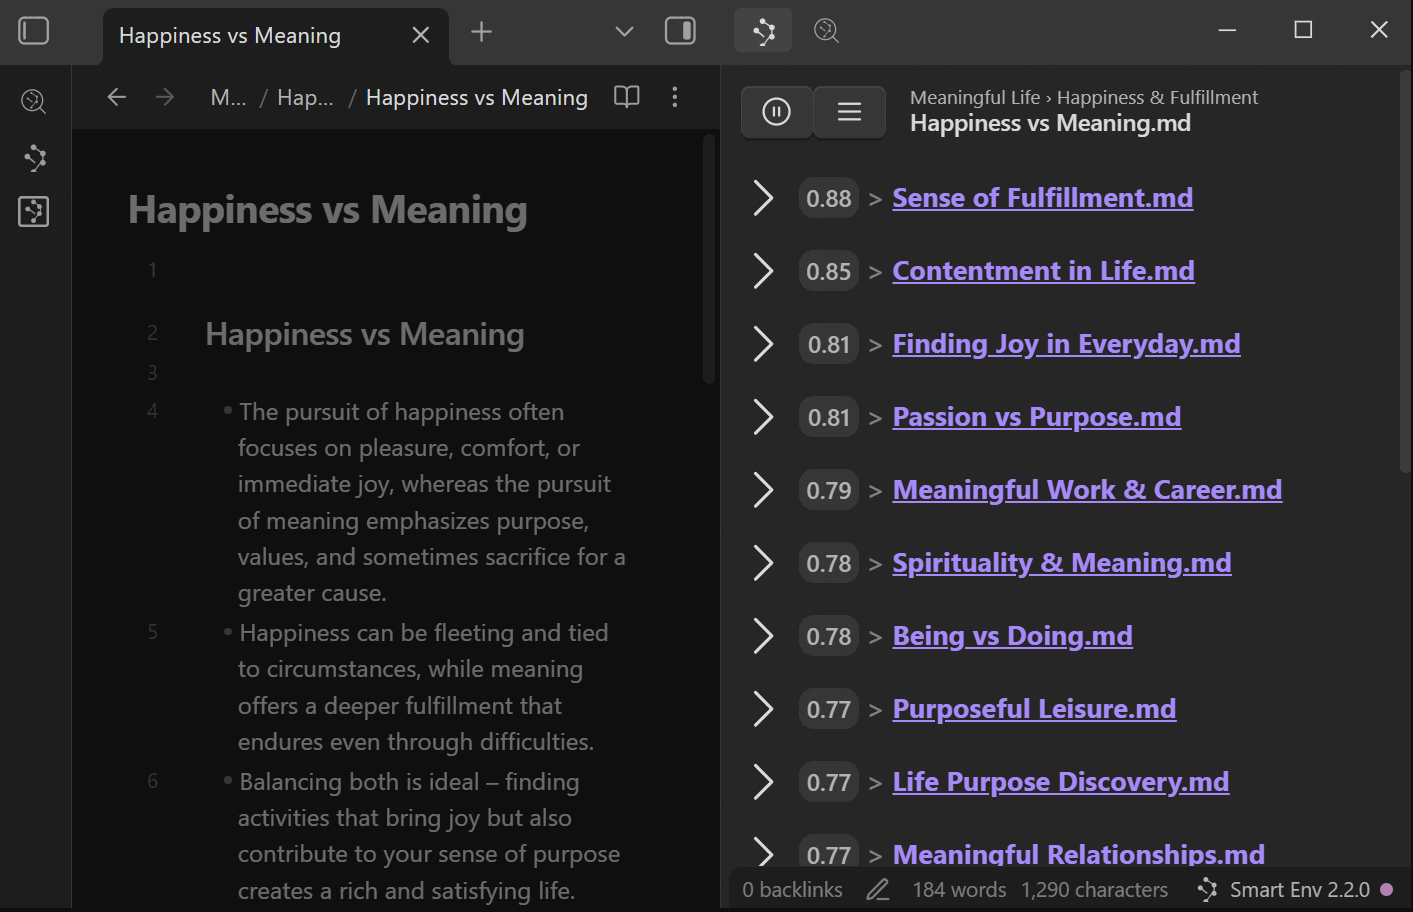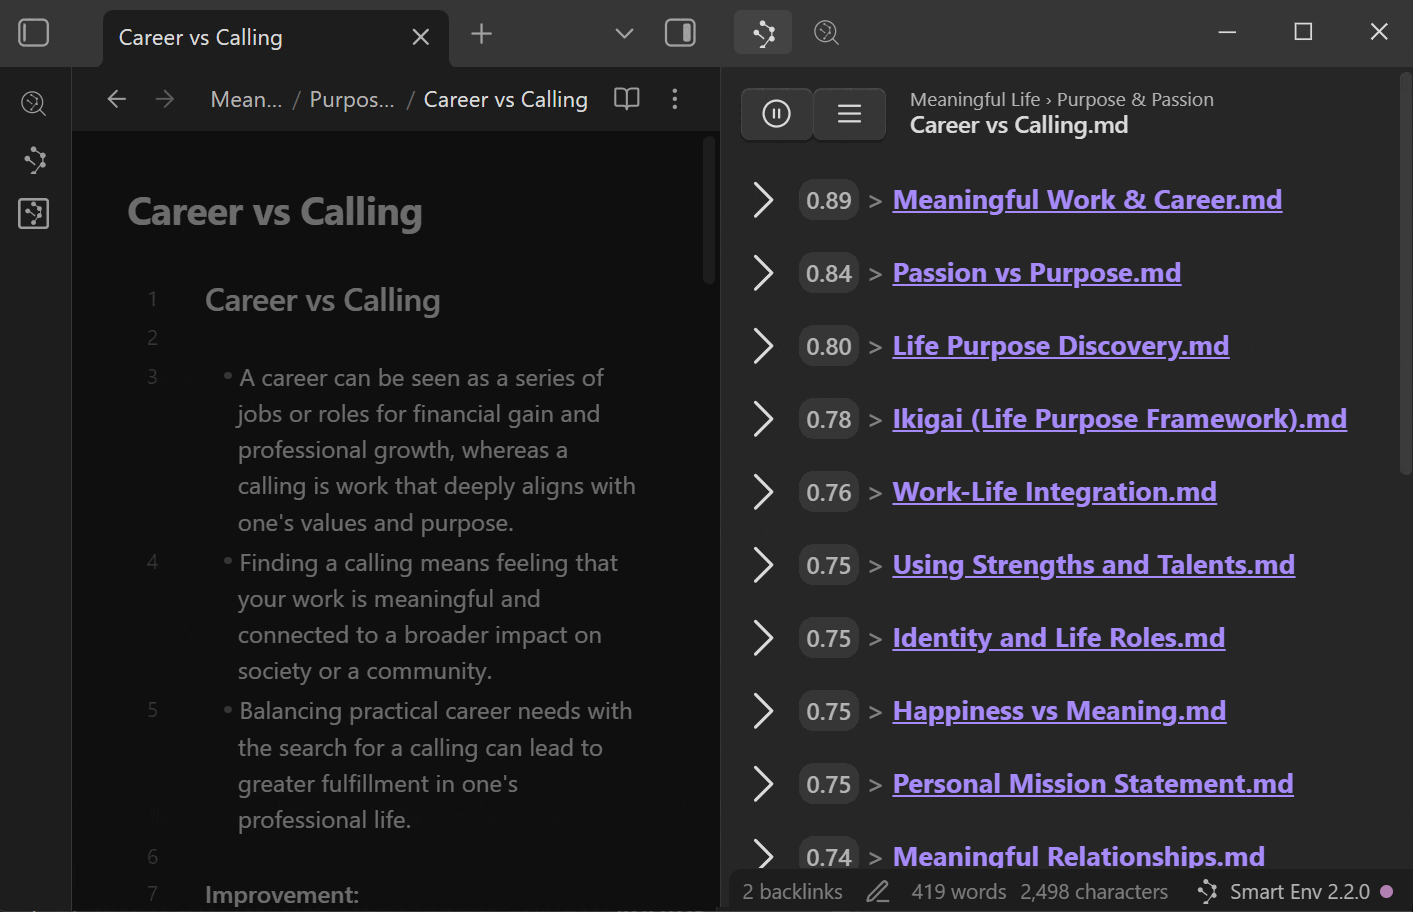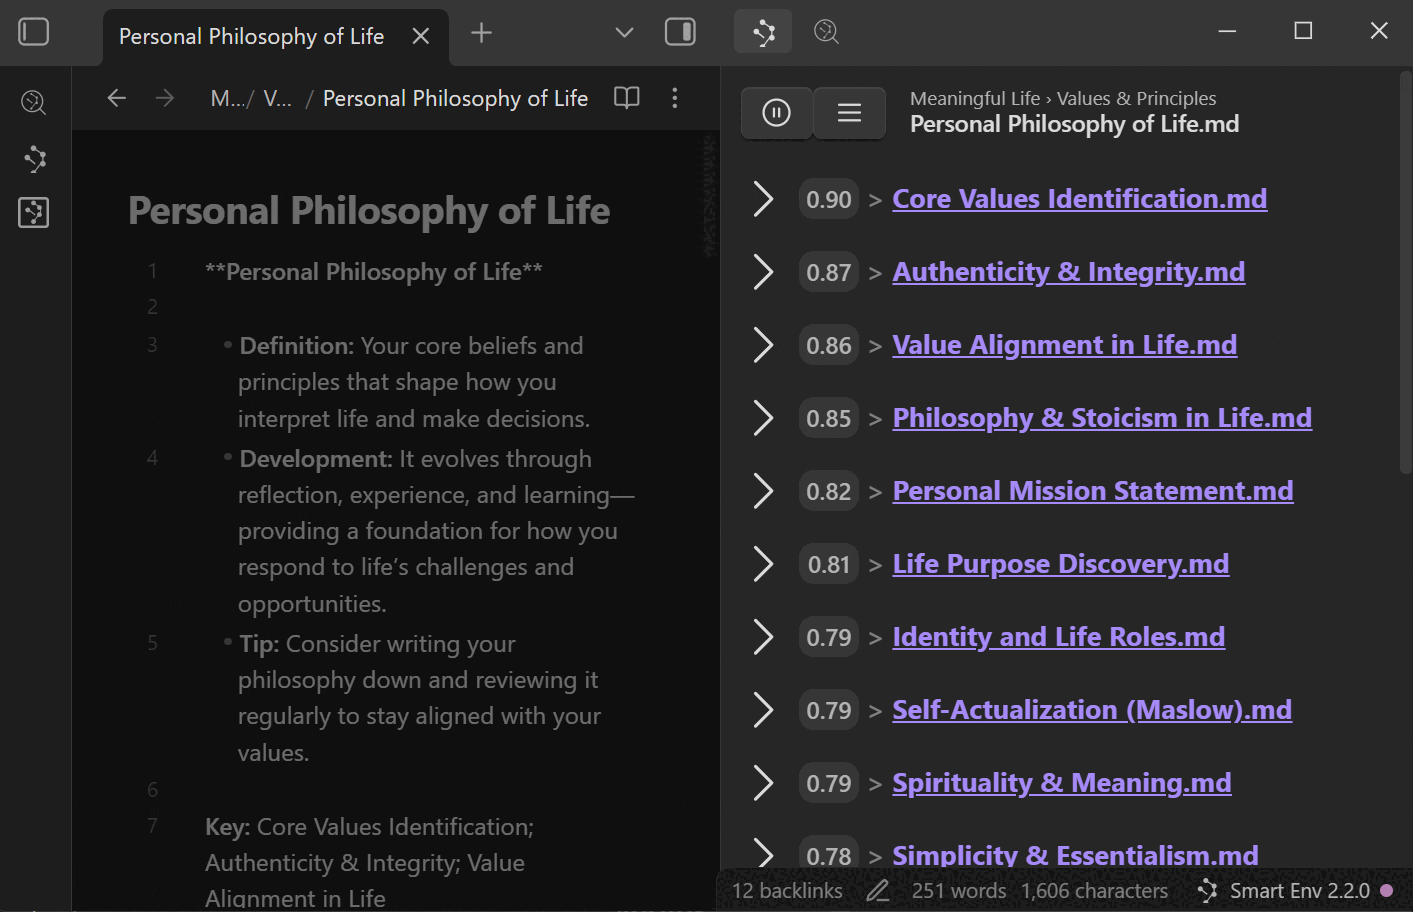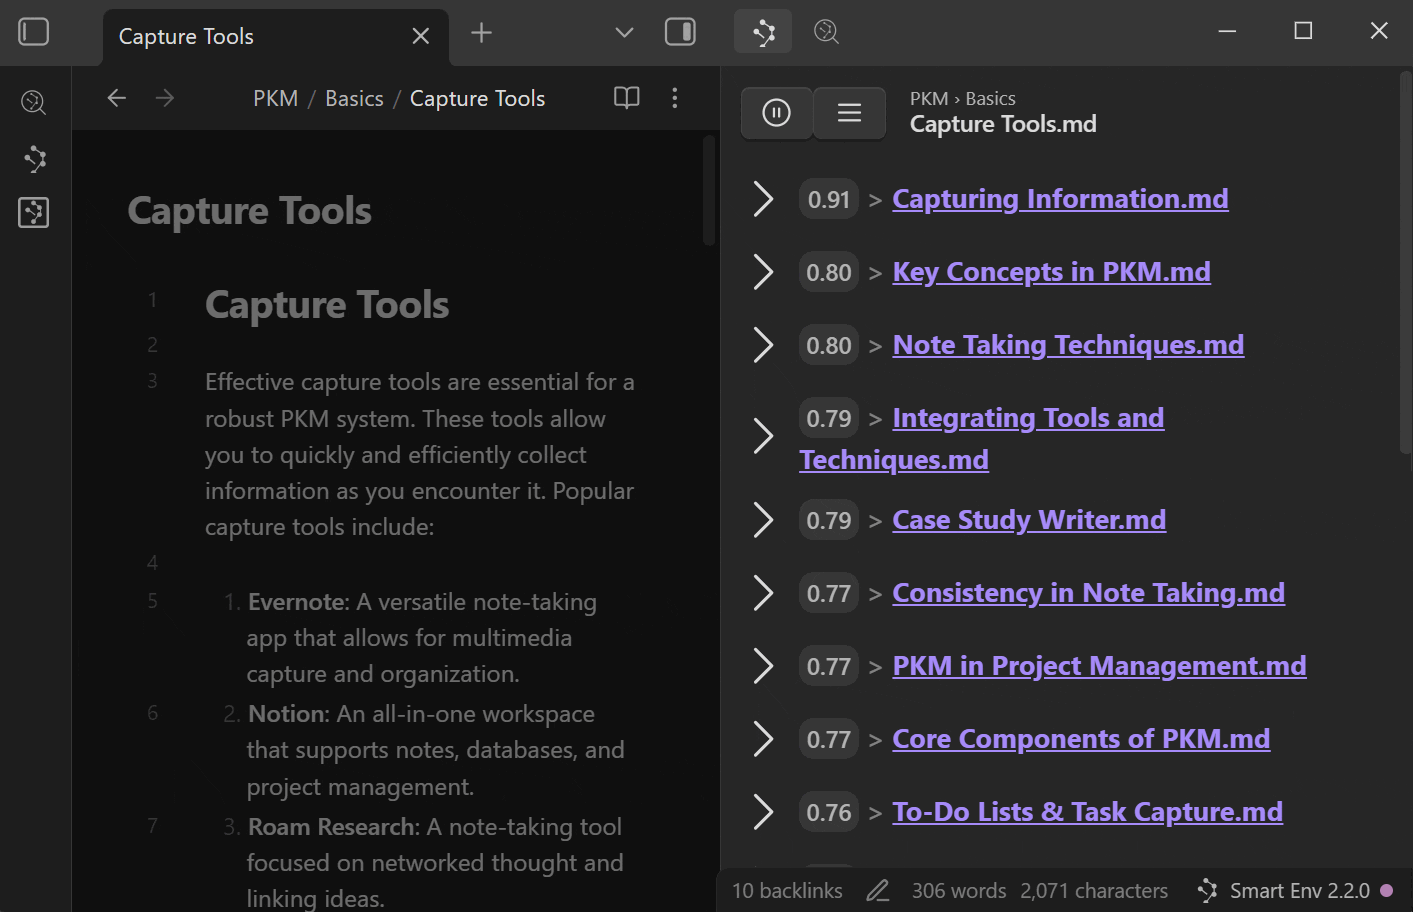
實證數據與配置細節:
目前此外掛已經全面支援 OpenAI 最新的 text-embedding-3-small 與 text-embedding-3-large 模型。根據官方定價,text-embedding-3-small 每 100 萬個 token 只要 0.02 美金。我自己的實測是:掃描一個包含 3,000 篇筆記(約 200 萬字)的 Vault,API 費用總共只花了 0.04 美金。
如果你跟我一樣討厭手動加 [[]] 雙向連結,這個外掛會是你的救星。
2. Copilot for Obsidian:如何配置最強的長文 RAG 對話助手?
這是我目前寫作時最常開著的側邊欄工具。它全面支援 GPT-4o 與 Anthropic 最新的 Claude 3.5 Sonnet / Opus 4.7。它的強項在於「精細控制」——你可以圈選一段幾萬字的會議紀錄,直接在對話框問「幫我抓出這場會議的三個最嚴重客訴」。
硬核功能:Chunk Size(文本切塊)
要讓 RAG 準確,你必須懂 Chunk Size。根據向量資料庫巨頭 Pinecone 發布的《Chunking Strategies for LLM Applications》指南,將 Chunk Size 設為適當大小(通常在 500 到 1000 tokens),並設定 10% 到 20% 的 Overlap(重疊率),能讓 AI 回答準確率達到最高。Copilot 完美支援了這項底層設定,讓你不再浪費不必要的 API Token。
3. Text Generator:如何建立自動化的提示詞模板?
如果你把 Copilot 當作「顧問」,那 Text Generator 就是你的「代筆仔」。它專注於內容創作,殺手級功能是支援「變數注入」的提示詞模板(Prompt Templates)。
舉個例子,你可以寫一個名為「會議總結」的腳本,腳本會自動讀取當前筆記的標題與日期,然後套用你寫好的 Prompt:「你是一個嚴格的專案經理,請把以下速記轉成表格,標出誰負責什麼事,並標註日期 {date}。」按下快捷鍵,表格就直接吐在游標位置。這不是改善工作體驗,這是本質上的流程改造。
4. BMO Chatbot:可以直接與自己的 Vault 抬槓嗎?
BMO Chatbot 的介面極度乾淨。它的核心優勢是支援「全局系統提示詞(System Prompt)」的覆寫。你可以為 BMO 設定一個「台灣資深軟體架構師」的人設,讓它每次回答都用台灣科技業的術語,並且優先給你程式碼範例,而不是給一堆廢話。
這對於不想搞懂複雜設定,只想打開對話框就開始問問題的新手來說,是摩擦力最小的選擇。
5. Vizier (Ollama):企業主唯一安全的本地機密解法?
這件事很多網路文章不敢講,但我必須把事實拆開攤在桌上:只要你用 OpenAI 或 Anthropic 的 API,你的資料就是會傳到別人的伺服器。如果你筆記裡有未公開的財報、客戶個資或是核心原始碼,你絕對不敢這樣玩。
Vizier 支援介接本地端的 Ollama 模型。這意味著你可以把 Meta 的 Llama 3 8B 或是阿里的 Qwen 2 直接下載到硬碟裡。就算你拔掉網路線,你依然可以叫 AI 幫你總結這份機密合約。
實證數據:你要買多好的電腦?
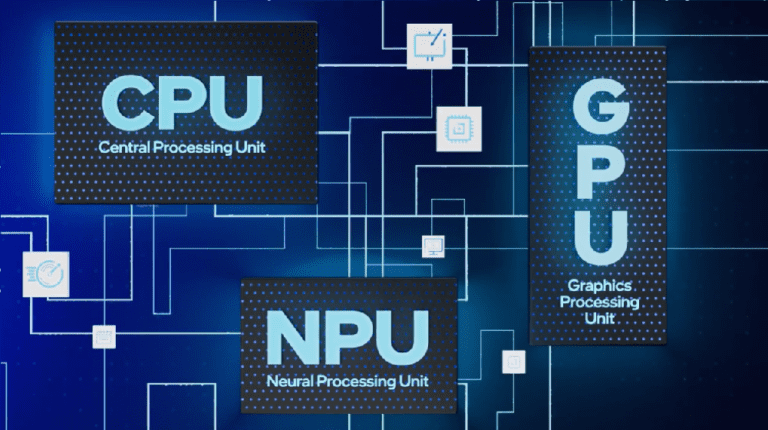
根據開源社群對 Ollama 的 VRAM(顯示記憶體)硬體實測:要流暢運行量化過(Q4_K_M)的 8B 參數模型,你的系統至少需要 6GB 到 8GB 的 VRAM,才能涵蓋模型體積加上大約 1.5GB 的 KV Cache 開銷。實測結果顯示,具備 16GB 以上統一記憶體的 Apple Silicon (M2/M3) Mac 能夠輕鬆勝任;如果是 Windows PC,你最好有一張 8GB VRAM 以上的獨立顯卡。如果你用文書機硬跑,系統會把負載轉移到 CPU,生成速度會慢到讓你懷疑人生。
進階玩法:Claude Code 與 Obsidian 可以深度整合嗎?
當你熟悉了上面這些 GUI 外掛後,我的下一個問題是:我們能不能用終端機直接操控整個筆記庫?
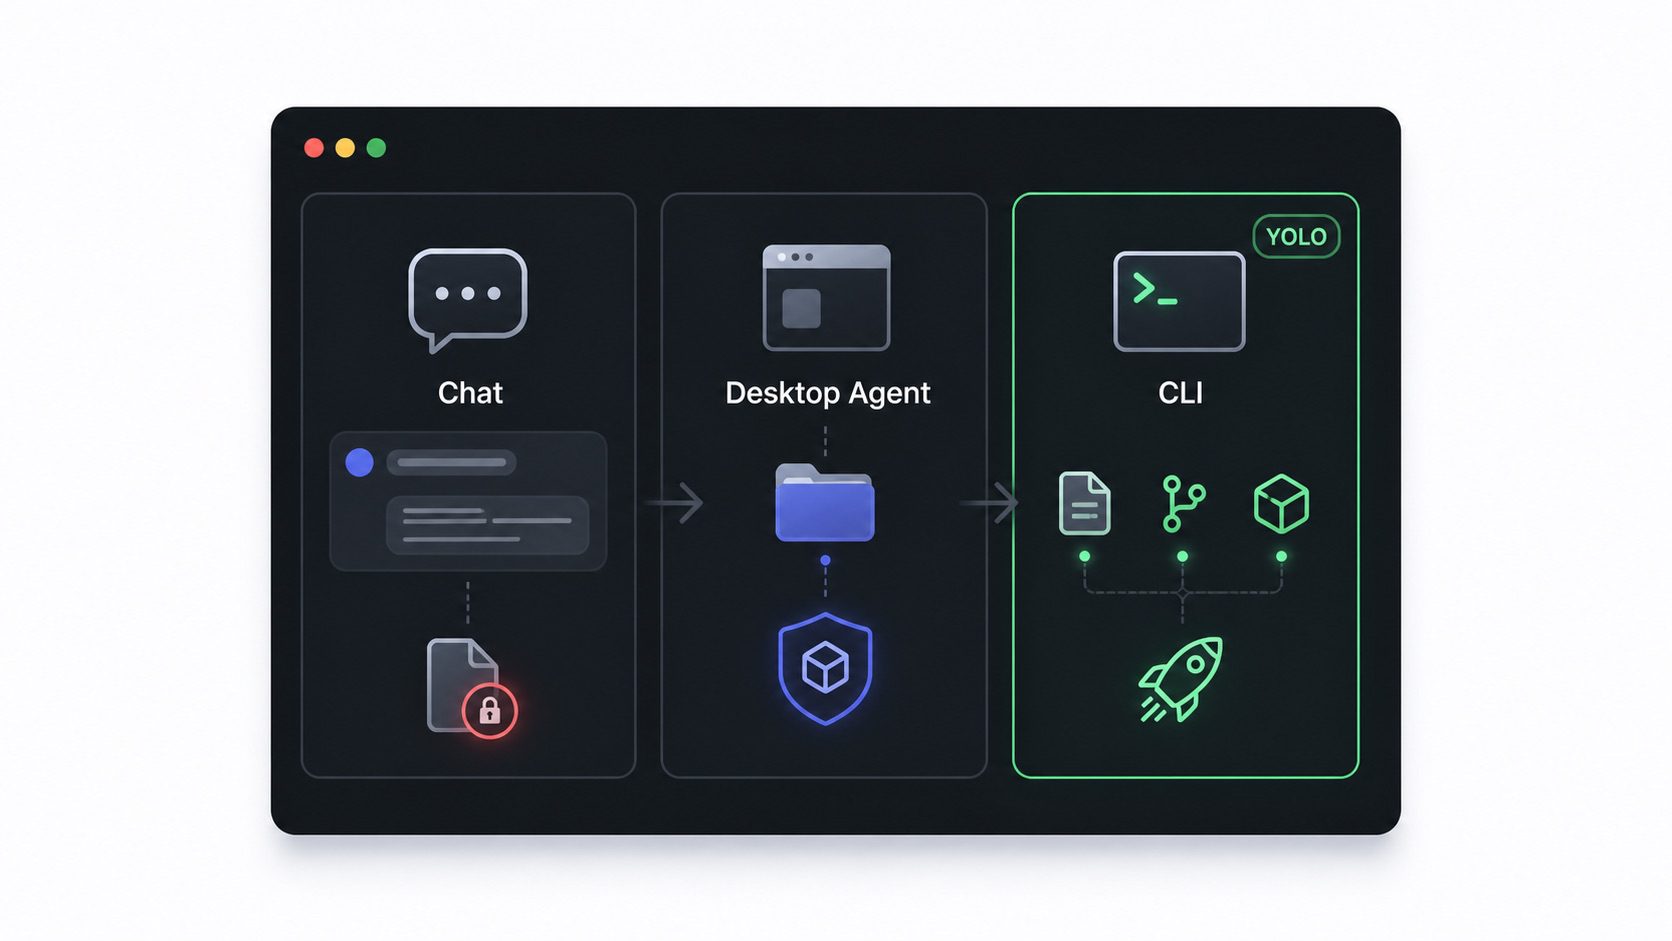
答案是肯定的。最近國外很紅的「LLM Wiki」架構,就是把 Obsidian 當作一個純文字資料庫,然後用 Anthropic 官方出的 CLI 工具 Claude Code 直接進去跑腳本。
舉例來說,你可以打開終端機,輸入:claude "幫我找出 2025 年所有關於 AI PC 的筆記,把裡面的規格資料整理成一個表格,寫入一份新的 Markdown 檔案。"
Claude Code 會自己去讀取檔案、自己找出關聯、自己新建檔案並寫入。這不是程度上的進化,這是本質上的改變,你的筆記庫正式變成了一個可以執行的程式。
台灣企業主與網站管理者決策摘要
看到這裡,你可能會想:這跟我的公司有什麼關係?我該怎麼選?
用一句話講:
- 如果你是一般行銷企劃、文字工作者:直接裝 Copilot for Obsidian + Smart Connections,綁定 OpenAI 或 Anthropic API。這是目前最聰明、設定最快的解法,一個重度使用者每個月的 API 費用通常不到 10 塊美金,這點錢買員工的效率絕對划算。
- 如果你是處理機密資料的企業主或資深工程師:不要用雲端 API。請直接投資硬體(例如買幾台 32GB RAM 的 Mac Studio 給核心團隊),裝上 Ollama 跑本地模型,搭配 Vizier 或 Copilot 的 Local 模式,確保機密資料 100% 不外洩。
結論:工具是地圖,最終看你自己的位置
不要看完這篇就把 5 個外掛全裝了,那只會讓你更焦慮。先挑一個解決你當下最大痛點的外掛(例如:老是找不到舊筆記,就裝 Smart Connections)。當你把一個工具用到極限,遇到瓶頸時,你自然會知道下一步該往哪裡走。
推薦閱讀
Claude Code + Obsidian 工作流教學:2026 最新 AI 第二大腦與 LLM Wiki 打造指南
最輕 NanoClaw:一個不會寫程式的新加坡外交部長 AI 第二大腦
Obsidian 教學:新手下載、入門設定、必裝外掛一次看懂
參考資料
2. OpenAI. Embeddings API Documentation.
3. Pinecone. Chunking Strategies for LLM Applications.
4. Ollama Documentation & LocalAI Community VRAM Requirements.
5. GitHub Repository: brianpetro/obsidian-smart-connections
常見問題 FAQ
Obsidian AI 外掛的 RAG 技術是什麼?
講白了,RAG(檢索增強生成)就是讓 AI 在回答你的問題前,先去你的筆記庫中翻找相關段落當作背景資料。這確保了 AI 是根據你個人的事實庫來回答,而不是憑空捏造。
為什麼 Smart Connections 找文章比傳統搜尋準確?
傳統搜尋只能比對字面是否相同,而 Smart Connections 使用向量嵌入(Embeddings)技術。它能理解整段文字的「語意」,即使你用的關鍵字不同,只要概念相近就能被找出來。
我的筆記資料會被外洩給 AI 公司嗎?
只要你使用了 OpenAI 或 Anthropic 的 API,你的文字就會傳輸到雲端。雖然多數商業 API 承諾不會拿用戶資料來訓練模型,但如果你的筆記包含企業機密資料,建議改用 Ollama 在本地端跑開源模型。
在本地端運行 AI 模型需要什麼硬體?
老實說,硬體門檻並不低。如果你要在本地端(如使用 Ollama)流暢運行中大型語言模型,你的電腦必須具備至少 8GB 到 16GB 的獨立顯示記憶體(VRAM),或者是擁有大容量統一記憶體的 Apple Silicon (M1/M2/M3) Mac。
企業主應該如何評估導入 AI 筆記系統的風險?
企業主在導入前應評估雲端 API 的合規性。如果資料機密等級高,你現在面對的不是要不要用 API,而是直接投資硬體算力,部署本地端模型,確保員工的知識庫在不連網的狀態下也能安全運作。