Jev 是什麼?前 OpenAI 研究者打造的決策 AI,他如何又快又便宜?
如果每天收到一萬封客服信,AI 能在讀完每封信後,迅速判斷「交給哪個部門、要不要優先處理」,而且整批的模型費用可能不到一美元,這會改變多少原本靠人手分派的工作?
Jev 最值得關注的能力,就是讓大量重複的小判斷,變得更快更便宜,也更容易接進工作流程。
TypeSafe AI 在 2026 年 9 月 15 日推出早期存取版 Jev,稱它為 System One Model,你可以先理解成「專門替軟體快速做判斷的 AI」,而這家公司背後,有一位曾參與 ChatGPT 重要前身研究的人物。
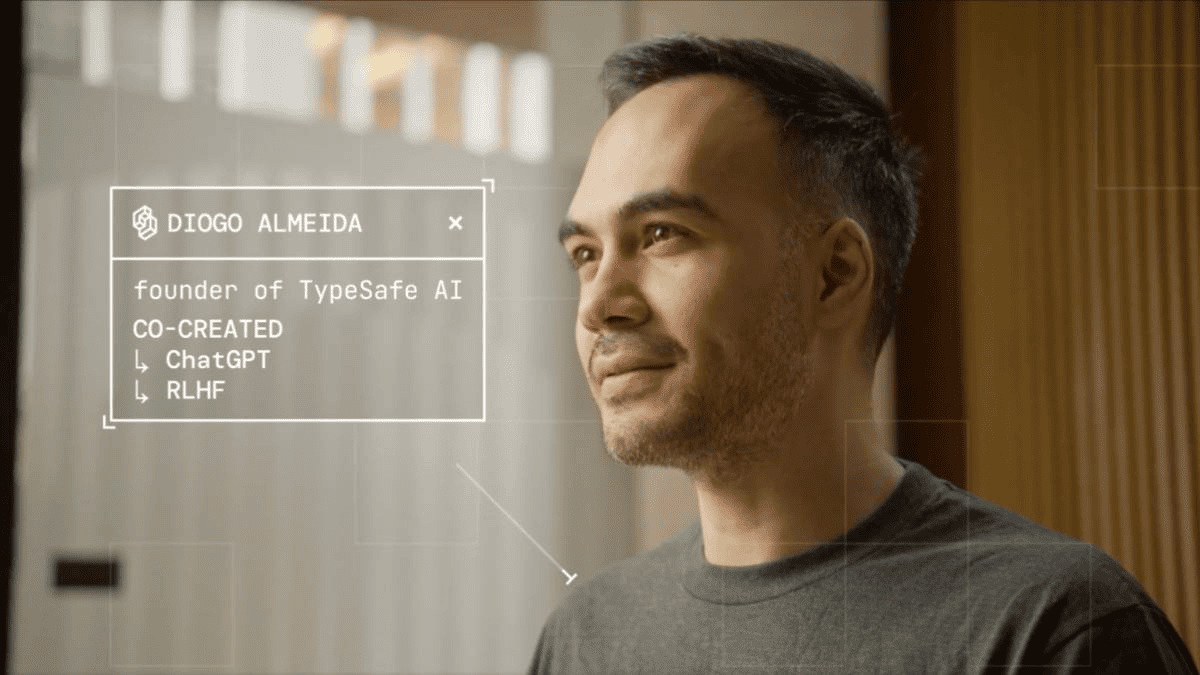
Jev 是誰開發的?創辦人 Diogo Almeida 厲害在哪?
Jev 是 TypeSafe AI 團隊的作品,其中共同創辦人暨執行長 Diogo Almeida 曾在 OpenAI 工作,官方團隊頁也列出他的 Google Brain 經歷,另外兩位共同創辦人是負責營運的 Sasha Sheng,以及負責技術的 Erik Gafni。
Diogo 最值得介紹的經歷,是他名列 2022 年 InstructGPT 論文的主要作者之一,這項研究處理一個很實際的問題:AI 即使讀過很多資料,也不代表能照使用者的要求好好回答。
研究團隊先讓人示範好的回答,再請人比較哪些答案更好,用這些回饋訓練模型,這類方法叫 RLHF,中文是「人類回饋強化學習」,白話說,像老師先示範,再批改作業,幫助 AI 學會什麼樣的回答比較符合人的需求。
成果有多突出?論文中,只有 13 億個參數的 InstructGPT,在該研究的人類偏好評估中,勝過 1,750 億個參數的原始 GPT-3,參數可以先想成模型內部學到的可調整數值,這個結果說明了:訓練方向對了,小得多的模型,也可能給出更受人偏好的回答。
這項工作和 ChatGPT 有直接關係,OpenAI 在 2022 年發布 ChatGPT 時,明確說明沿用了 InstructGPT 的 RLHF 方法,並調整資料蒐集方式,因此 Diogo 的份量在於參與了讓 AI 更能聽懂指令的重要研究,這是團隊共同成果。
已經有 ChatGPT,為什麼還要開發 Jev?
Diogo 在 Jev 發布文中提出的核心疑問是,AI 已經這麼會聊天了,為什麼大量工作還沒有順利自動化?
他把這個問題當成持續研究的方向,TypeSafe 則經過兩年未公開的開發,才推出 Jev。
用客服工作理解就很清楚,AI 寫得出一封漂亮回信,和系統能不能快速把一萬封信送到正確部門,是不同的能力,後者需要每一步都能接著執行,還要處理等待時間、費用,以及拿不準時怎麼辦。
TypeSafe 的想法,是把 AI 判斷變成軟體可以反覆使用的小功能,像積木一樣組成流程,讓 AI 理解信件意思,讓一般程式負責查訂單、計算金額與執行規則,這也正是 Jev 想補上的位置。
先用客服信,搞懂 Jev 和 LLM 差在哪
LLM 是 Large Language Model 的縮寫,中文叫「大語言模型」,你可以先把它理解成從大量文字中學習語言規律、能根據上下文產生回答的 AI,常見用途包括聊天、摘要、翻譯和寫作。
Jev 比較像客服中心的分流人員,讀完來信後,在事先設定好的選項裡做判斷,將結果交給下一個系統處理,官方支援的題目包括選一個選項、依標準評分,以及估計某件事成立的機率。
假設客人寫來:「我昨天付了款,訂單卻一直顯示付款失敗,明天就要用,請幫我確認」,下面是為了說明分工設計的情境,並非實際測試結果。
| 你要完成的工作 | 可以怎麼分工 |
|---|---|
| 判斷交給帳務、物流還是技術支援 | 讓 Jev 從預設部門中選擇 |
| 判斷是否需要優先處理 | 讓 Jev 按設定的緊急程度評分 |
| 寫一封有禮貌、說明清楚的回信 | 交給能生成文字的 LLM |
| 確認是否真的收到款項 | 查訂單與付款系統,不能只憑 AI 猜測 |
這裡的「固定格式」,正式說法叫結構化輸出,你可以把它想成填表格,部門填哪一欄、緊急程度有哪些選項,都先規定好,程式才容易接著做事。
要注意,LLM 也能分流和產生結構化輸出,Jev 的差別是專門為這類決策設計,並非只有它能填表格,LangChain 的整合說明也將 Jev 定位為生成式模型的搭配工具,而非直接替換品。
Jev 厲害在哪?把快速判斷變成能接著做事
多個小問題一起判斷,減少一步一步等待
常見的生成式 LLM 會依序產生文字片段,這些片段叫 token,它可能是一個字、一部分單字或標點,不等於固定數量的中文字。
Jev 則同時評估事先列好的問題,直接回傳選項與機率等結果,省去自由文字生成的過程,Vercel 已在 9 月 16 日公布整合,讓開發者能把這類判斷接進軟體。
用前面的客服例子理解,部門、緊急程度、是否要求退款,可以根據同一封信一起判斷,再由系統整理成待辦事項,當一個流程有許多這類小問題,減少每次等待,就更有機會把時間省在整個流程上。
不過同時回答多題有前提,各題是根據同一份資料獨立判斷,如果第二題必須知道第一題的答案,還是要安排前後步驟,不能把整個工作流程都想成瞬間完成。
結果可以直接交給程式,讓分流變成自動流程
你先定義好「帳務、物流、技術、其他」等選項,Jev 就依這套規格回傳答案與各選項的機率,程式可以接著分派案件,這種把結果限定在指定格式與選項內的設計,能減少後續整理答案格式的工作。
對使用者而言,實際價值是少一個「看完 AI 回答,再手動轉交」的步驟,LLM 也能做到固定格式輸出,Jev 要爭取的優勢,是把這類判斷做得更快、更省,接下來的數據就是要檢查這件事。
把拿不準的案件挑出來,集中人工注意力
如果兩個部門的機率很接近,系統可以先送人工確認,答案明確的案件則照既定規則處理,這是官方介紹的應用方式,白話說,就是讓人把時間花在難分的案例上,是否真的能省下人工,仍要拿自己的資料驗證。
「又快又省」有哪些數據?
我會把證據分成公開價格、官方測試、外部測試者紀錄,三者能回答的問題不同。
| 項目 | 公開數字 | 應該怎麼解讀 |
|---|---|---|
| 官方回應時間 | 70~500 毫秒,約 0.07~0.5 秒 | 官方多從美國西岸呼叫當地服務,台灣實際等待時間仍需測試 |
| 輸入與輸出價格 | 每百萬輸入 token 0.042 美元,輸出 0 美元 | 這是模型使用費,不是整套系統的總成本 |
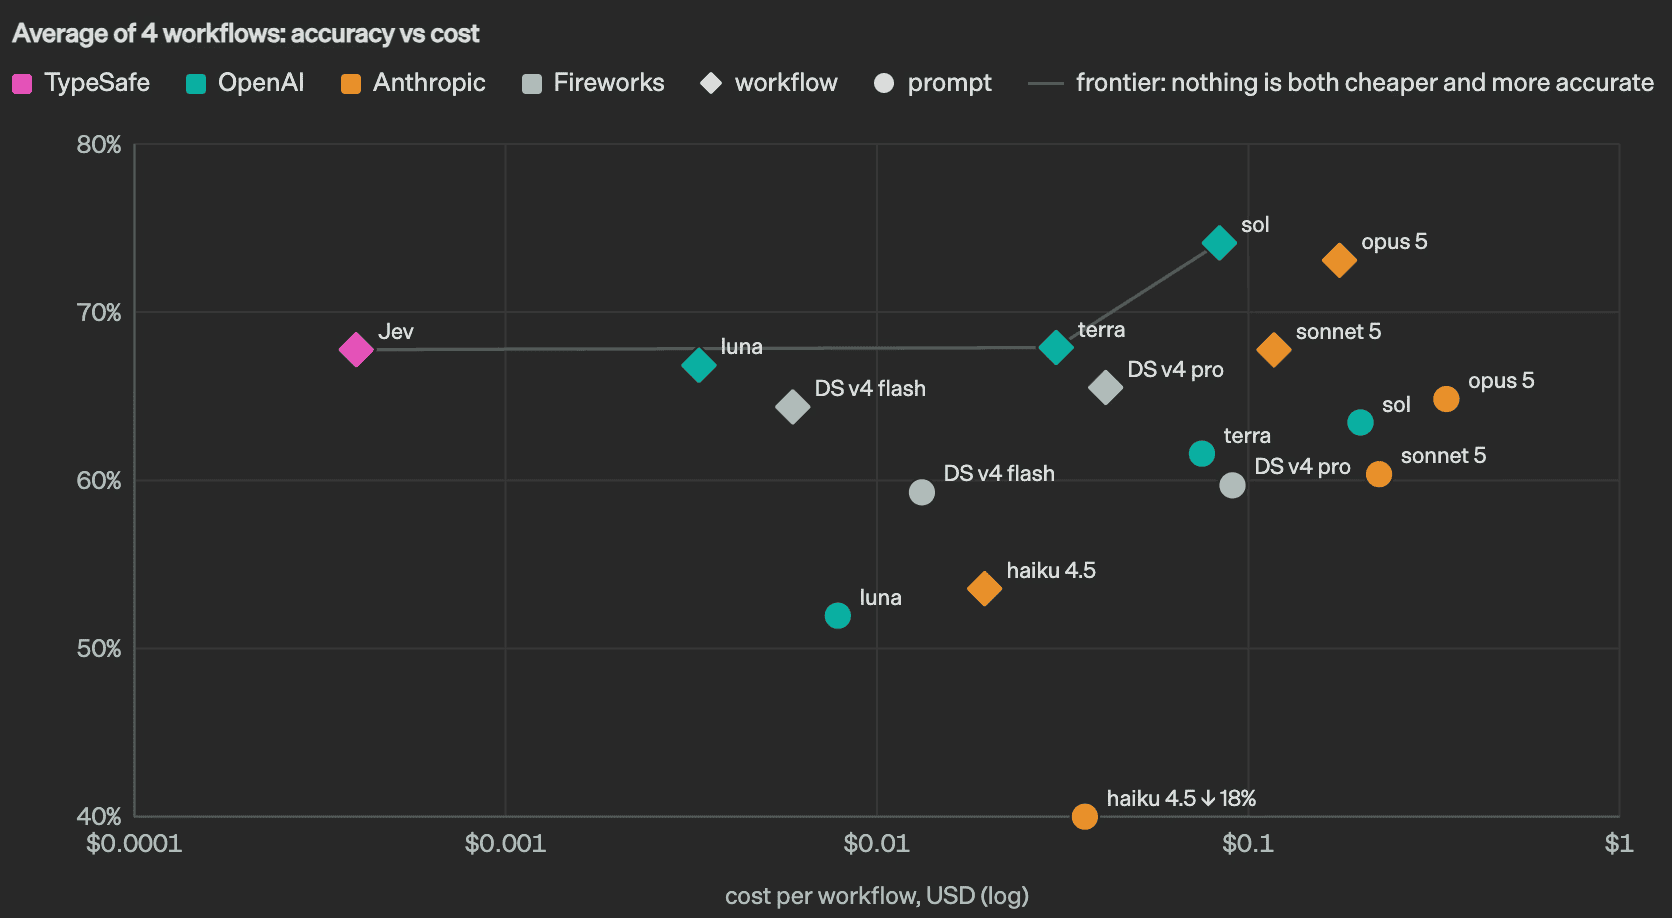
| 官方工作流程比較 | 宣稱最高快 193.6 倍,費用約為對照的 1/444.6 | 特定測試下的主張,不能當成所有任務的固定倍率 |
速度與倍數來自 TypeSafe 發布資料,官方也提醒,亮眼倍率可能接近實際收益的上緣,價格另可在 OpenRouter 的 Jev 頁面交叉核對。
官方怎麼測?答案由誰判定?
官方評估包含資安事件、AI 代理的執行紀錄、發票處理與客服決策,AI 代理可以先理解成「會串接工具、接著執行下一步的 AI 系統」,例如查完訂單,再決定是否轉人工。
測試把工作拆成小問題與程式規則,四類工作占同樣比重,參考答案由高推理設定的 GPT-6 Astra 和 Claude Fable 5.1 產生,也就是讓這兩個模型投入較多計算來思考,其他受測模型採供應商預設設定,因此,分數反映的是符合這套參考答案的程度,不能直接當成真實營運的正確率。
LLM 也能設定成只回簡短選項,速度比較要連同任務與輸出要求一起看,官方比較中的 LLM 還必須回傳機率,這會影響時間與費用,193.6 倍與 444.6 倍各自對應的比較模型與設定,本文尚未核實,所以保留為官方測試主張。
有官方以外的實測嗎?有,但規模和任務有限
開發者 Maxim Saplin 在 9 月 17 日公布自己的西洋棋測試,Jev 的紀錄為 80 局,平均每局約 35.6 秒、費用約 0.0015 美元,80 局合計約 0.12 美元。
這份結果有參考價值,但 Jev 是從程式提供的合法走法中挑選,聊天模型則透過多輪工具操作下棋,互動方式並不相同,不能直接拿表中的時間差當成公平的通用速度排名,更不能拿棋力推論客服判斷一定準確。
所以如果問「快又省是不是只有傳聞」,答案是已有公開數據與外部測試紀錄,如果問「能不能證明所有任務都便宜幾百倍」,目前這些證據還不夠。
一萬封客服信,費用到底有多低?
只看「每百萬 token 0.042 美元」不太有感,我們用一個假設試算,假設每封信連同必要背景、問題與選項,一次送進模型共用 2,000 個輸入 token,每封只呼叫一次。
一萬封信 × 2,000 token = 2,000 萬 token,也就是 20 個「百萬 token」,按上述單價計算,模型輸入費為 20 × 0.042 = 0.84 美元。
這是算式示例,不是實測帳單,2,000 token 也不代表 2,000 個中文字,如果一封信要呼叫好幾次、附上很長的對話紀錄,費用就要重新計算,還沒算進工程串接、系統維護及人工複核。
另一個重點:讓系統知道哪些答案需要再確認
AI 幻覺,是指 AI 產生看似合理、實際上沒有根據或不正確的內容,TypeSafe 宣傳中的保證,要放在預先限定的輸出格式與選項內理解。
假設你只給「帳務、物流、技術」三個部門,系統不會憑空填出第四個部門,但本來該轉帳務的信,仍可能被分到物流,填對欄位和選對答案,是兩件事。
Jev 的另一個重點是訓練它合理表達機率,官方把這套訓練方法稱為 RLCD,白話說,就是不只要求選答案,也要求它對「這個答案有多大可能成立」提供有參考價值的數字。
例如一大批標示「80% 可能成立」的預測,理想上約八成真的成立,這叫機率校準,描述的是很多次預測合起來的表現,不是任何一次回答的保證。
這裡還有一個容易混淆的詞:confidence,中文常翻成信心值,Jev 的這個數字是根據各選項的機率分布計算,反映答案有多集中,信心值 0.9 並不直接等於答對率 90%,要用自己工作的資料驗證後,才能決定哪些情況自動處理、哪些交給人看。
Jev 怎麼用?新手先用網頁做一次客服分流
第一次接觸,我建議先完成一個小練習:貼上一封信,請 Jev 判斷部門與是否有急迫需求,下面依官方操作流程設計,輸入與結果解讀都是教學示例,本文沒有登入帳號執行這組測試。
打開 Playground,貼上要判斷的文字
前往 TypeSafe Playground 網頁試用介面 並登入,Jev 發布時採早期存取,若帳號尚未開通,就依官網指引申請或候補。
在 State 放進下列範例文字,State 就是「提供給 AI 判斷的資料」,目前 Jev 接受文字,不直接接受照片、聲音或影片。
範例文字:「我昨天付了款,訂單卻一直顯示付款失敗,明天就要用,請幫我確認」。
加一題 Choice,先決定交給哪個部門
Choice 就是選擇題,問題可以寫「這封客服信應優先交給哪個部門?」,接著定義選項與範圍,這些規則由你提供,Jev 不會自動知道你的公司分工。
| 選項 | 提供給 Jev 的判斷標準 |
|---|---|
| 帳務 | 付款、扣款、發票或款項狀態有問題 |
| 物流 | 已出貨後的配送進度、包裹遺失或送錯地址 |
| 技術 | 登入或操作功能故障,且不屬於付款問題 |
| 其他 | 以上皆不符合,或資訊不足以分派 |
加入「其他」很實用,因為真實來信不一定剛好落在你的分類裡,先留一個可以人工查看的出口,也比較容易找出哪些規則需要補充。
再加一題 Noul,判斷有沒有急迫需求
Noul 是官方替「是非題的機率判斷」取的名字,問題可以寫「這封信是否表達明確的使用期限或急迫需求?」,它會回傳 0 到 1 的數字,越接近 1,代表模型越傾向判斷為「是」,這裡量的是該敘述成立的機率,不是緊急程度的分數。
設定好後執行查詢,兩題可以一起送出,先確認回傳的是「部門選項」與「是否急迫的機率」,而不是期待它寫出一封客服回信。
看懂結果,再決定下一步怎麼做
用示意結果說明,如果部門回傳「帳務」,急迫需求的機率也很高,你就能設計成「送進帳務待辦,並標記優先」,如果帳務與技術的機率很接近,就先交人工確認,這是流程設計示例,不是這段輸入的實測答案。
網頁練習能幫你看懂判斷方式,要讓新信自動進來、結果自動送到待辦清單,還需要透過 API 串接,API 可以理解成讓兩套軟體傳資料、請對方做事的接口,Jev 負責回傳判斷,收信與派工由你串接的系統執行。
先拿 20 封已由你分好類的範例信試跑,這是我建議的入門練習量,把預期部門和 Jev 結果逐一對照,哪種最常分錯,就回頭把選項範圍寫清楚,20 封足以幫你理解操作,正式大量使用前仍需要更多代表性案例。
哪些人值得用 Jev?先找出你反覆做的小判斷
如果你主要用 AI 寫文章、整理想法、討論企劃,繼續用擅長文字生成的工具即可,Jev 沒有提供自由文字生成,把它當成下一個聊天軟體,會期待錯方向。
如果你每天要把客服信分部門、替文件歸類,或判斷使用者的問題該交給哪個工具,Jev 就有明確的試用價值,這些工作共同的特徵是:資料很多、選項能事先定義、同一種判斷會重複發生。
比較時至少看實際等待時間、模型費用、判錯比例,以及最後需要多少人工複核,單次回應很便宜,但常常判錯,和單次稍貴卻能減少重工,是不同的經營結果。
對我來說,Jev 最有想像空間的地方,是讓原本因為太慢、太貴而不值得交給 AI 的小工作,也有機會被自動處理,從一封信的分流開始,當這種判斷每天重複上千次,速度、費用與容易串接的輸出,才會一起變成有感的改變。
參考資料
- TypeSafe:創辦人與團隊背景
- InstructGPT:原始論文與作者名單
- OpenAI:ChatGPT 的訓練方法與 InstructGPT 關係
- TypeSafe:產品理念與自動化目標
- TypeSafe:Jev 發布公告與測試限制
- TypeSafe:Jev 入門與問題設計
- TypeSafe:網頁試用與快速開始
- TypeSafe:System One 與支援的輸入
- TypeSafe:Choice 選項與判斷規則
- TypeSafe:Noul 是非題機率
- TypeSafe:工作流程評估方法
- TypeSafe:訓練目標與機率校準
- TypeSafe:信心值的定義與使用方式
- Vercel:Jev 整合公告
- LangChain:Jev 的應用與分工
- OpenRouter:Jev 公開定價
- Maxim Saplin:Jev 西洋棋測試紀錄
常見問題 FAQ
Jev 是大語言模型嗎?
Jev 的產品定位和一般生成文字的 LLM 不同,TypeSafe 稱它為 System One Model,主要回傳預先定義的選項、評分與機率,不提供自由文字生成。
Jev 可以直接替我寫文章嗎?
不能像聊天型 LLM 那樣直接產生完整文章,它較適合協助文章分類、判斷內容是否符合某個條件等決策步驟,實際寫作仍需搭配文字生成工具。
Jev 輸出免費,就代表完全不用錢嗎?
不是,公開定價仍收取輸入費,每百萬 token 為 0.042 美元,若透過其他平台或整合服務使用,還要確認該服務的計費方式,工程與人工成本也不包含在模型價格內。
不會寫程式,可以直接開始用嗎?
有存取權限後,可以先用官方 Playground,也就是網頁試用介面,貼上文字並設定問題,不一定要先寫程式,要自動處理大量工作,通常仍需透過 API,也就是讓軟體互相呼叫的介面來串接,發布時採早期存取,能否立即使用仍以帳號權限為準。