GMI Cloud API 真的比官方便宜?20 款模型價格與低價原因解析
GMI Cloud 是另一個購買 AI 服務的管道,讓你的程式或 AI 工具,透過同一個平台使用不同公司的 AI 模型。
真的比官方便宜嗎?
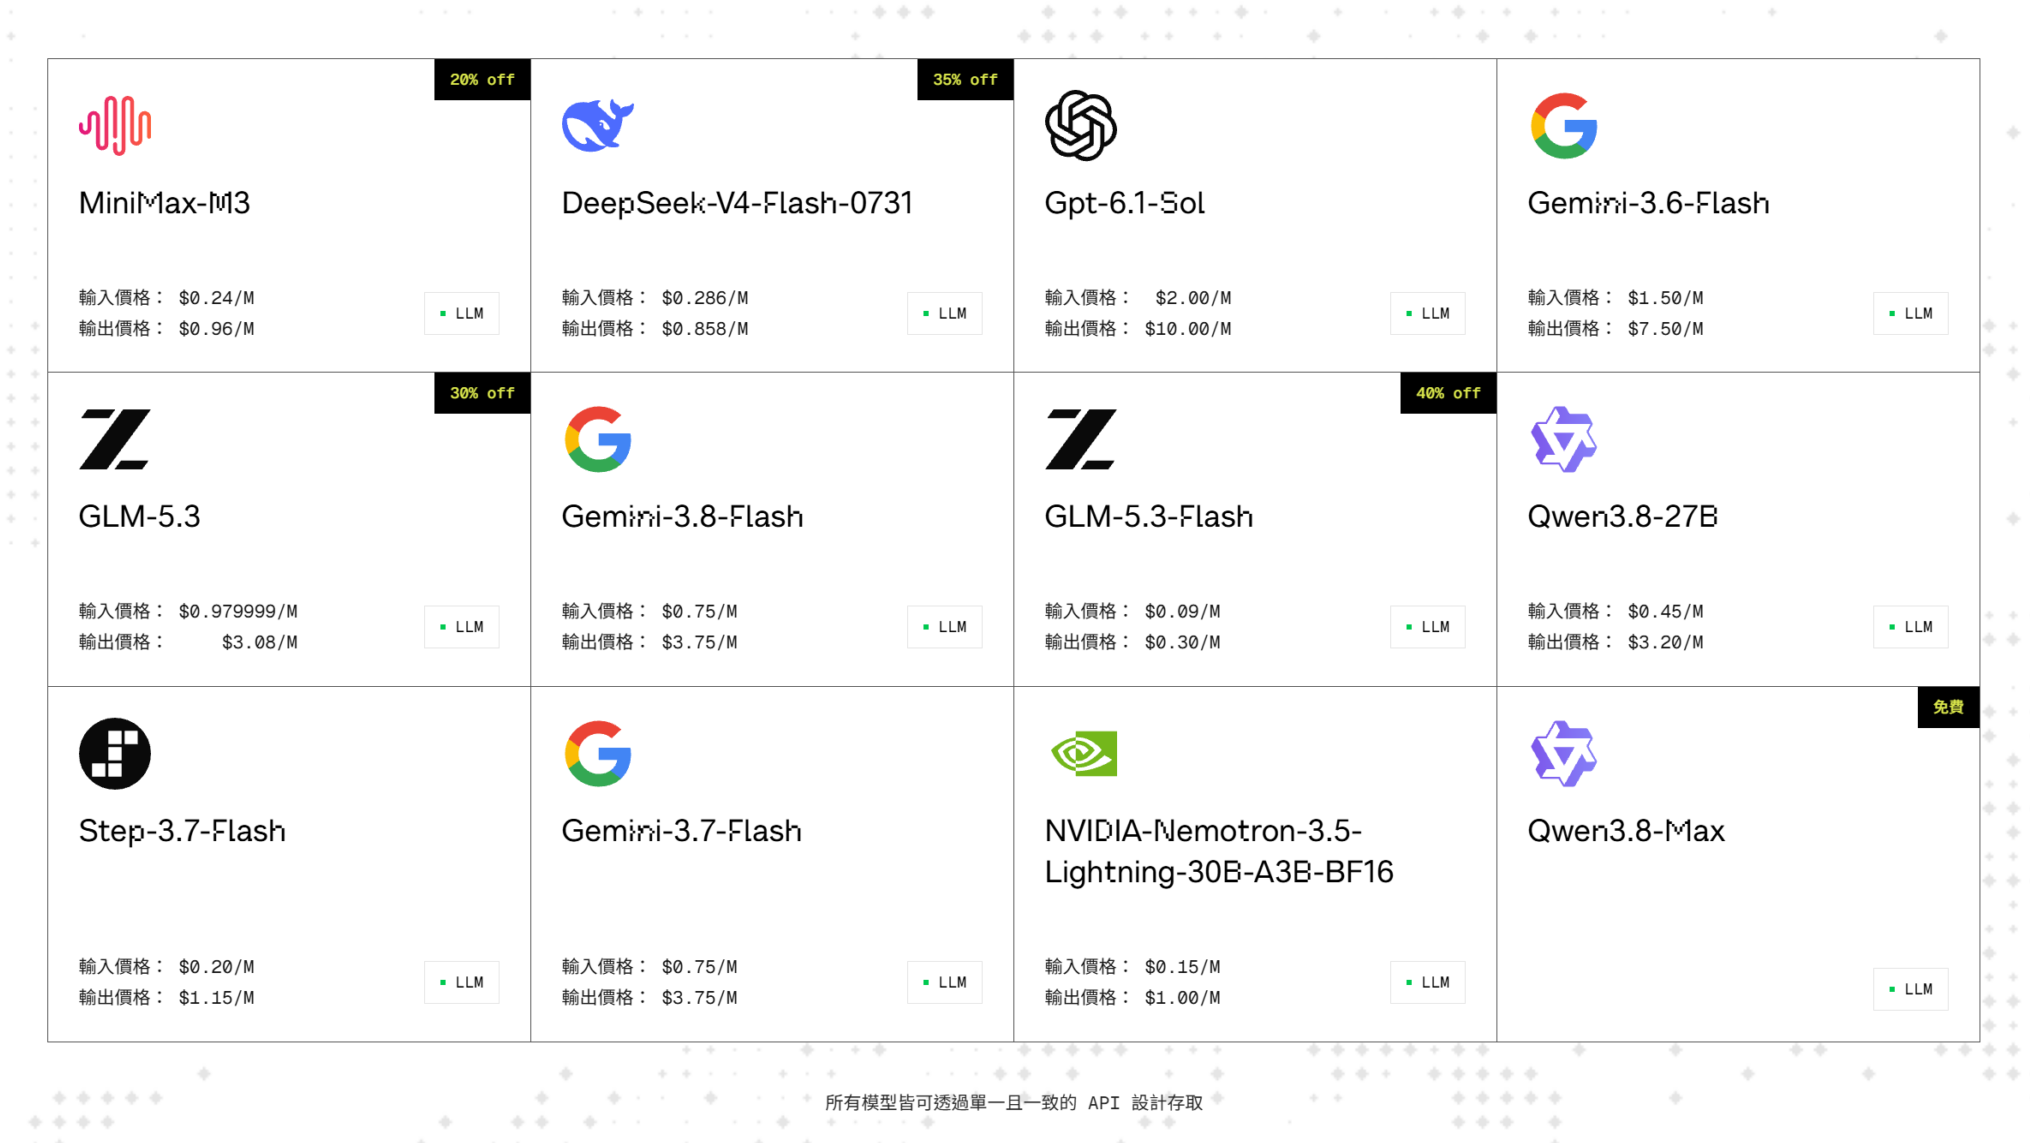
有些確實比較便宜,依本文的報價比較,部分 GLM 與 MiniMax 模型可以省下 20% 到 40%,但本文列出的 GPT 與多數 Gemini 模型和官方同價,也有 GMI 比官方貴的例子。
所以要看你用的是哪一款 AI,以及怎麼使用,不能看到平台有折扣,就把所有模型都當成比較便宜。
為什麼它可以賣得比原廠便宜?
部分模型由 GMI 用自己的機器運行,再透過技術減少重複運算,讓同一批機器處理更多工作。平均成本降低,就有提供低價的空間,合作促銷也能帶來優惠。這些是公開資料支持的低價途徑,個別模型的實際成本與採購合約並未全部公開。
會不會偷偷降智,換成比較弱的 AI?
目前能確認的是部分報價較低,回答品質是否相同還缺實測。
價格低可以來自營運效率與促銷,單看售價無法判斷模型有沒有被換掉。
要確認,就把相同問題交給兩邊,在版本與設定一致的條件下,比較有沒有答錯、漏掉重點,或需要反覆重做。
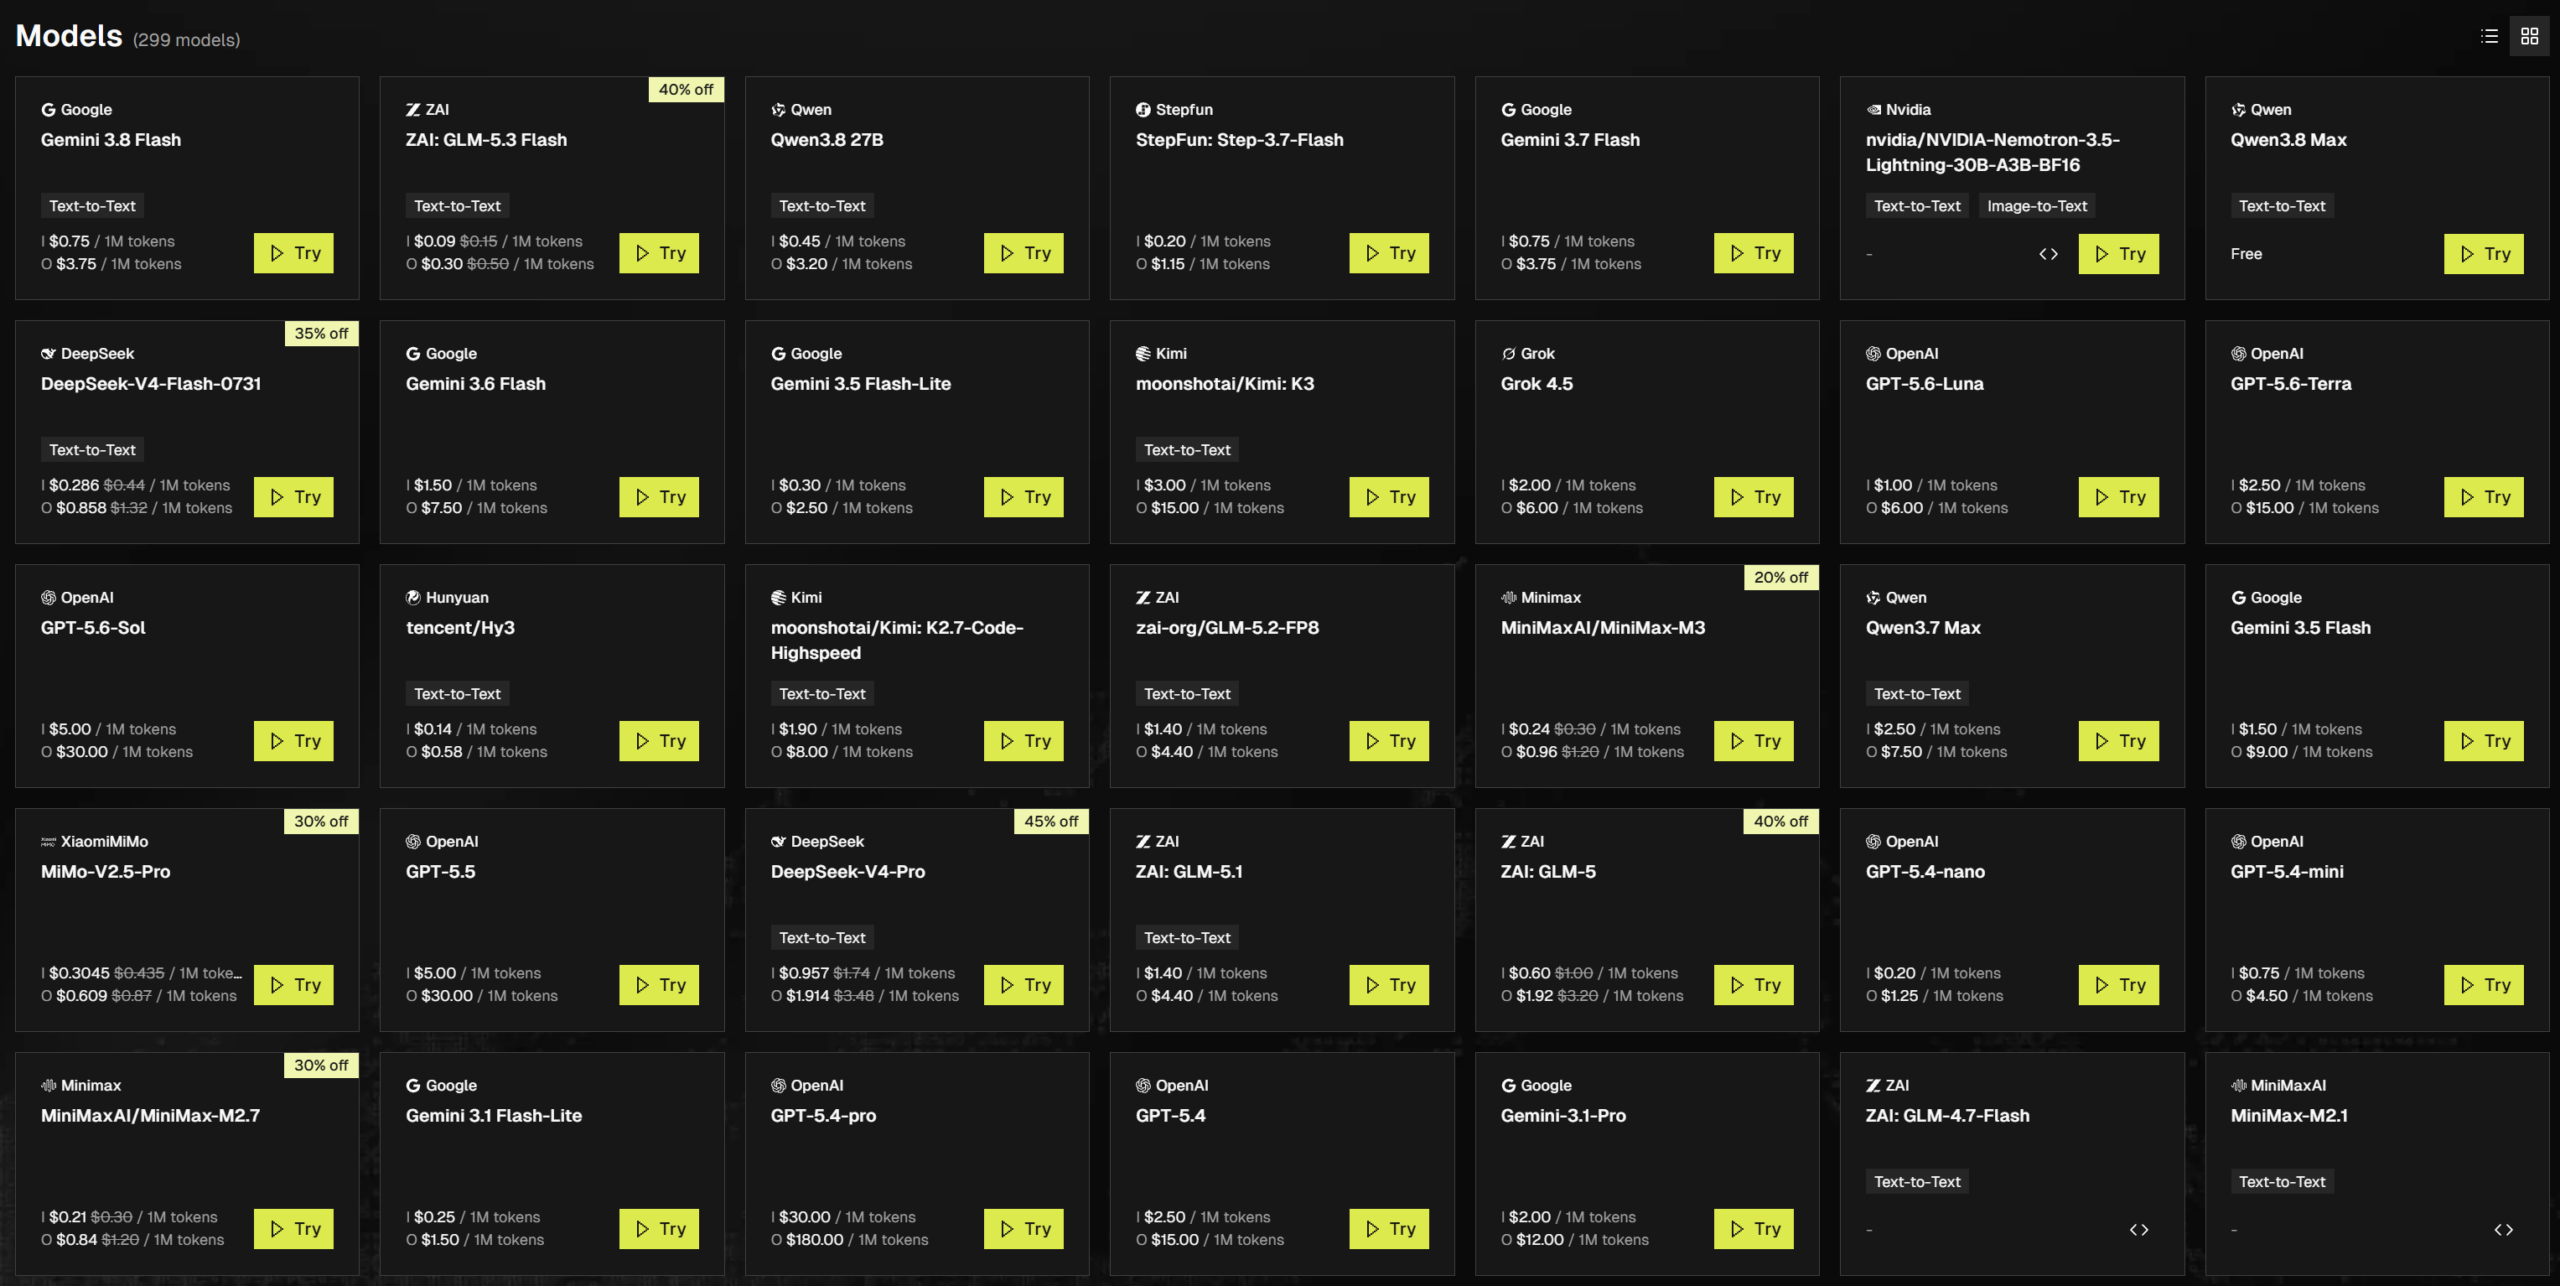
比價格之前,先把「官方價」與「折扣價」對齊
本文以 GMI Model Hub(模型目錄)的報價樣本,對照各模型開發商公開的美元 API 價格,token(文字計費單位)是模型處理與計費的單位,文字表格統一使用「每 100 萬 tokens、美元」,官方採一般隨用隨付方案,Batch(整批提交,稍後取得結果)、優先處理與離峰方案另外比較。
GMI 的定價文件指出,最新模型費率與地區加價要到控制台的 Model Hub 查詢,因此本文的 GMI 欄位是該報價樣本的對照結果。
閱讀價格表時,先抓住三件事:
- 刪除線價格要另外核對:GMI 的原價與優惠價屬於平台報價,刪除線本身無法證明它等於原廠現行價。
- 輸入、輸出與快取(重用已處理過的內容)要分開算:大量讀文件和大量生成內容,最後帳單可能差很多。
- 原廠自己的優惠也要計入:官方批次、離峰與有效優惠價,都是實際可以選擇的採購方案。
GLM 與 MiniMax:GMI 的折扣有明確數字支持
以下官方費率分別採 Z.AI 國際 API 價目與 MiniMax 美元隨用隨付價目,所有數字皆為美元/100 萬 tokens,輸入指一般未命中快取的輸入。
這篇對照 20 款文字模型的同名報價,在一般標準費率、DeepSeek 採尖峰費率的條件下,GMI 有 7 款較便宜、12 款同價、1 款較貴,換成 DeepSeek 離峰費率,那 2 款 DeepSeek 都會變成官方較便宜。
這張表可以看到,只有指定版本有折扣,同品牌其他版本仍然同價。
| 模型 | 官方輸入/輸出 | GMI 輸入/輸出 | 快取讀取:官方 → GMI | 報價結果 |
|---|---|---|---|---|
| GLM-5.3-Flash | 0.15/0.50 | 0.09/0.30 | 0.03 → 0.018 | 便宜 40% |
| GLM-5.3 | 1.40/4.40 | 0.98/3.08 | 0.26 → 0.182 | 約便宜 30% |
| GLM-5 | 1.00/3.20 | 0.60/1.92 | 0.20 → 0.12 | 便宜 40% |
| GLM-5.1 | 1.40/4.40 | 1.40/4.40 | 0.26 → 0.26 | 同價 |
| GLM-4.7(GMI 標示 Proxy) | 0.60/2.20 | 0.60/2.20 | 0.11 → 0.11 | 同價 |
| MiniMax-M3 | 0.30/1.20 | 0.24/0.96 | 0.06 → 0.048 | 便宜 20% |
| MiniMax-M2.7 | 0.30/1.20 | 0.21/0.84 | 0.06 → 0.042 | 便宜 30% |
| MiniMax-M2.5 | 0.30/1.20 | 0.30/1.20 | 0.03 → 0.03 | 同價 |
GLM-5.3 的 GMI 樣本顯示輸入價為 0.979999 美元,表格四捨五入成 0.98 美元,後面的費用試算也採這個數字。
這組比較最有價值的地方,是部分模型的輸入、輸出與快取讀取都約有相同比例的折扣,像 GLM-5.3-Flash 三項都是 40%,MiniMax-M2.7 三項都是 30%,在兩邊計費用量一致、只計這三種費用的前提下,總額也會按同一比例下降。
但 GLM-5.1、GLM-4.7 與 MiniMax-M2.5 都是同價,光看「這家有 GLM」或「這家有 MiniMax」,還不能判斷值得搬過去。
MiniMax M3 要用官方已打折的價格比較
MiniMax 官方已把 M3 的 512k 以內輸入費率,從 0.60/2.40 美元下調成 0.30/1.20 美元,GMI 的 0.24/0.96 美元,相對官方有效價省下的是 20%。
如果拿官方刪除線的舊價來比,會算出 60% 的折扣,這個數字卻沒有回答「現在直接買原廠,要比 GMI 多付多少錢」。
M3 單次輸入超過 512k tokens 時,官方會改用另一組費率,本文採 512k 以內比較,GMI 樣本沒有列出相同的長輸入分級,這張表的 20% 結論應用於上述範圍。
GPT、Gemini 與 Grok:同價很常見,還有 GMI 較貴的例子
以下對照 OpenAI 官方價格、Google Gemini API 官方價格與 Grok 4.6 官方模型文件,單位仍為美元/100 萬 tokens。
這張表可以看到,GPT、Grok 與多數 Gemini 同價,但 Gemini 3.6 Flash 的 GMI 報價比官方有效優惠價更高。
| 模型 | 官方輸入/輸出 | GMI 輸入/輸出 | 快取讀取:官方 → GMI | 報價結果 |
|---|---|---|---|---|
| gpt-6.1-sol | 2.00/10.00 | 2.00/10.00 | 0.10 → 0.10 | 同價 |
| gpt-6-astra | 10.00/50.00 | 10.00/50.00 | 1.00 → 1.00 | 同價 |
| gpt-6-luna | 0.10/0.50 | 0.10/0.50 | 0.01 → 0.01 | 同價 |
| Gemini 3.8 Flash | 0.75/3.75 | 0.75/3.75 | 0.075 → 0.075 | 同價 |
| Gemini 3.7 Flash | 0.75/3.75 | 0.75/3.75 | 0.075 → 0.075 | 同價 |
| Gemini 3.6 Flash | 0.75/3.75 | 1.50/7.50 | 0.075 → 0.15 | 貴 100% |
| Gemini 3.5 Flash | 1.50/9.00 | 1.50/9.00 | 0.15 → 0.15 | 同價 |
| Gemini 3.5 Flash-Lite | 0.30/2.50 | 0.30/2.50 | 0.03 → 0.03 | 同價 |
| Gemini 3.1 Flash-Lite | 0.25/1.50 | 0.25/1.50 | 0.025 → 0.025 | 同價 |
| grok-4.6 | 2.00/6.00 | 2.00/6.00 | 0.50 → 0.50 | 同價 |
GPT 三款採官方短上下文 Standard 價,Grok 採官方頁面列示的 us-east-1 基本費率與 200k 以內上下文,Gemini 3.1 Flash-Lite 採文字輸入價,這些條件要跟著表格一起讀。
Gemini 3.6 Flash 的價差來自官方有效優惠
Google 對 Gemini 3.6、3.7、3.8 Flash 公告的優惠到 2026 年 12 月 31 日結束,3.6 Flash 的有效輸入/輸出價為 0.75/3.75 美元,GMI 樣本仍列 1.50/7.50 美元,兩項都是官方的兩倍。
同一份 GMI 樣本中的 3.7 與 3.8 Flash,卻已經是 0.75/3.75 美元,所以價差要逐個版本看,平台上存在同價的新版本,也存在高於官方優惠價的版本。
Google 已公告這三款 Flash 的標準輸入/輸出價將在 2027 年 1 月 1 日改成 1.50/7.50 美元,優惠期限會改變比較基準,不能把這段期間的價差永久化。
長上下文看起來很便宜,也可能只是漏看分級
GPT-6.1 Sol 模型文件列明,單次提示超過 272k 輸入 tokens,整筆請求的輸入與快取費率變為兩倍,輸出費率變為 1.5 倍。
GMI 樣本只列出一組基本費率,單憑這張表,無法判斷長上下文是否另有加價,因此本文把 GPT 的「同價」限定在短上下文基本費率,長文件工作的成本需要另外對齊兩邊的分級規則。
DeepSeek:比尖峰便宜,比離峰貴
DeepSeek 官方價格頁同時列出底層版本與兩種時段費率,目前 deepseek-flash 對應 DeepSeek-V4.1-Flash,deepseek-v4-pro 對應 DeepSeek-V4-Pro-0813。
這張表可以看到,DeepSeek 在尖峰用 GMI 比較省,能排到離峰時,官方價格更低。
| 模型 | GMI 輸入/輸出/快取 | 官方尖峰輸入/輸出/快取 | 官方離峰輸入/輸出/快取 | GMI 相對結果 |
|---|---|---|---|---|
| DeepSeek-V4.1-Flash | 0.18/0.72/0.0036 | 0.30/1.20/0.006 | 0.15/0.60/0.003 | 尖峰便宜 40%,離峰貴 20% |
| DeepSeek-V4-Pro-0813 | 1.056/3.168/0.0352 | 1.32/3.96/0.044 | 0.66/1.98/0.022 | 尖峰便宜 20%,離峰貴 60% |
官方尖峰是週一到週五的 UTC 01:00–04:00、06:00–10:00,換成台灣時間為 09:00–12:00、14:00–18:00,中國法定假日除外,其餘時段、週末與中國法定假日全天都算離峰。
這會直接改變工作流程的採購選擇,台灣上班時間需要即時回應的工具,可以比較 GMI 的折扣,能安排在晚上或週末執行的文件整理、翻譯與資料處理,官方離峰費率反而更低。
混合使用時段,要看尖峰用量占多少
假設同一模型在尖峰與離峰的輸入、輸出、快取用量比例一致,用 p 代表「落在尖峰的用量比例」,官方混合費用就等於「全部離峰費用 ×(1+p)」。
這張表可以看到,Flash 的尖峰用量超過 20%、Pro-0813 超過 60% 時,GMI 才在這組假設下比較省。
| 模型 | GMI 費用相對「全離峰官方費用」 | GMI 與官方損益兩平條件 |
|---|---|---|
| V4.1-Flash | 1.2 倍 | 尖峰用量占 20% |
| V4-Pro-0813 | 1.6 倍 | 尖峰用量占 60% |
換句話說,Flash 的尖峰占比超過 20% 時,GMI 報價在這組假設下較省,Pro-0813 則要超過 60%,如果尖峰時段特別常生成長答案,就應分別計算輸入與輸出的時段用量,不能只拿請求次數代替 token 用量。
官方 Batch:願意等待,省下的可能更多
對客服聊天、即時 coding 來說,延遲會影響使用體驗,對整批分類、翻譯、測試資料生成來說,隔一段時間拿到答案常常可以接受,兩種工作應採不同的計費方案。
OpenAI Batch API提供相對同步 API 50% 的折扣與 24 小時完成窗口,Gemini Batch API也採標準價格的一半,目標完成時間為 24 小時。
下表只比較文字輸入/輸出費率,GPT 採短上下文,Gemini 3.8 採前述優惠期間,單位為美元/100 萬 tokens。
這張表可以看到,工作能等到整批處理完成時,官方 Batch 的輸入與輸出費率比 GMI 一般報價更低。
| 模型 | GMI 一般報價 | 官方 Standard | 官方 Batch | 相對 GMI 可省 |
|---|---|---|---|---|
| GPT-6.1 Sol | 2.00/10.00 | 2.00/10.00 | 1.00/5.00 | 50% |
| GPT-6 Astra | 10.00/50.00 | 10.00/50.00 | 5.00/25.00 | 50% |
| GPT-6 Luna | 0.10/0.50 | 0.10/0.50 | 0.05/0.25 | 50% |
| Gemini 3.8 Flash | 0.75/3.75 | 0.75/3.75 | 0.375/1.875 | 50% |
| Gemini 3.1 Flash-Lite | 0.25/1.50 | 0.25/1.50 | 0.125/0.75 | 50% |
這是不同服務條件下的採購比較,GMI 樣本的一般價對上原廠批次價,不能稱為同等即時服務的價格差,但如果工作本來就能等待,這個差異才是預算真正應該計入的選項。
換成月用量,價差到底有多大?
假設一個文字工作流程每月使用 1 億輸入 tokens、2,000 萬輸出 tokens,全部輸入都未命中快取,每次請求都在前面列出的基本費率範圍,只算文字 token 費用。
月費算法是「100 × 輸入單價+20 × 輸出單價」,以下是費率試算,未加入稅、匯差、充值贈額、工具呼叫與其他費用。
這張表可以看到,同樣的月用量下,折扣比例和最後省下的金額是兩件事。
| 模型 | GMI 月費 | 官方一般/尖峰月費 | GMI 相對差異 |
|---|---|---|---|
| GLM-5.3-Flash | $15.00 | $25.00 | 省 $10.00,40% |
| GLM-5.3 | $159.60 | $228.00 | 約省 $68.40,30% |
| MiniMax-M3 | $43.20 | $54.00 | 省 $10.80,20% |
| MiniMax-M2.7 | $37.80 | $54.00 | 省 $16.20,30% |
| DeepSeek-V4.1-Flash | $32.40 | 尖峰 $54.00,離峰 $27.00 | 尖峰省 $21.60,離峰多 $5.40 |
| DeepSeek-V4-Pro-0813 | $168.96 | 尖峰 $211.20,離峰 $105.60 | 尖峰省 $42.24,離峰多 $63.36 |
| GPT-6.1 Sol | $400.00 | Standard $400.00,Batch $200.00 | Standard 同價,Batch 多 $200.00 |
| Gemini 3.8 Flash | $150.00 | Standard $150.00,Batch $75.00 | Standard 同價,Batch 多 $75.00 |
| Gemini 3.6 Flash | $300.00 | 優惠期 Standard $150.00 | 多 $150.00,100% |
從這張表可以看出,折扣百分比和實際節省金額是兩件事,GLM-5.3-Flash 的 40% 折扣,在這個用量下只省 10 美元,GPT-6.1 Sol 改用官方 Batch,卻能省 200 美元。
對企業來說,我會先估算一年省多少錢,再判斷是否值得改程式、重跑品質評估與搬動工作流程,低用量的 40% 折扣,未必足以支付一次串接的工時。
快取費率,也要加上寫入與儲存條件
假設 MiniMax M3 的每月 1 億輸入 tokens 中,有 9,000 萬命中快取、1,000 萬未命中,輸出仍為 2,000 萬,只算輸入、輸出與快取讀取,GMI 為「10 × 0.24+90 × 0.048+20 × 0.96=25.92 美元」,官方為 32.40 美元。
這比兩邊都未命中快取時的 43.20/54.00 美元更低,GMI 的相對折扣仍為 20%,這是兩邊真的達到相同快取命中率時的試算,不能把表格列出快取價格直接當成已達成 90% 命中。
完整預算還要加入快取建立、寫入與儲存,OpenAI 的快取說明及 Google 價目都有相應計費規則,GMI 樣本中的 Write 欄位,也不能在缺少時間與保留條件的情況下直接對齊 Google 的每小時快取儲存價。
Veo 影片:每秒、每次與解析度,不能混在一起比
GMI Model Hub 的影片欄位常顯示「美元/Request」,但 GMI Veo Fast 文件明確寫每秒 0.15 美元,因此畫面上的 0.15 不能直接理解成一整支影片只收 0.15 美元。
以下採 GMI 的 veo-3.1-generate-001、veo-3.1-fast-generate-001、veo-3.1-lite-generate-001 文件報價,對照 Google Cloud Veo 價目與 Google Gemini API 的每秒計費說明,所有結果均以 8 秒影片計算。
影片也有相同情況,Veo 3.1 Fast 在 720p、含音訊的設定下,GMI 文件報價比 Google 高 50%,因此真正有用的問題是「我的模型、使用時段與輸出規格,在哪裡買比較划算」。
這張表可以看到,Veo Fast 在 720p、含音訊時官方比較便宜,其他結果要按每秒價格與輸出規格逐項看。
| 模型與輸出條件 | GMI 每秒價 | Google 每秒價 | GMI 8 秒費用 | Google 8 秒費用 | 結果 |
|---|---|---|---|---|---|
| Veo 3.1 Standard,720p+音訊 | $0.40 | $0.40 | $3.20 | $3.20 | 同價 |
| Veo 3.1 Fast,720p+音訊 | $0.15 | $0.10 | $1.20 | $0.80 | GMI 貴 50% |
| Veo 3.1 Lite,720p+音訊 | $0.05 | $0.05 | $0.40 | $0.40 | 同價 |
| Veo 3.1 Lite,1080p+音訊 | $0.08 | $0.08 | $0.64 | $0.64 | 同價 |
| Veo 3.1 Lite,720p 無音訊 | $0.03 | $0.03 | $0.24 | $0.24 | 同價 |
| Veo 3.1 Lite,1080p 無音訊 | $0.05 | $0.05 | $0.40 | $0.40 | 同價 |
GMI Veo Lite 文件把四種規格分別列價,這也解釋了為什麼同一個 Lite 模型,會出現 0.03、0.05、0.08 三種單價。
Standard 與 Fast 的 GMI 文件只列一個每秒單價,這裡採文件預設的 720p、含音訊條件比較,4K 與其他模式需核對完整報價,不能直接把基本價套到所有規格,再宣稱比 Google 的高解析度價便宜。
如果每月生成 100 支 8 秒、720p、含音訊的 Fast 影片,GMI 報價試算為 120 美元,Google 為 80 美元,會差 40 美元,但這是生成成本,成片可用率與重做次數還會影響最後每支可交付影片的成本。
GMI 為什麼有辦法賣得比模型原廠便宜?
有些折扣已經可以從公開價格證明,接下來要處理的是成本與商業模式,公開資料支持的機制包括原生部署、推論效率與聯合促銷,各閉源模型的採購價、毛利與折扣出資方則沒有足夠公開資訊可直接確認。
部分模型在 GMI 自己的基礎設施執行
GMI 的公司介紹列出自有資料中心與 NVIDIA H100、H200、Blackwell 平台,這表示它有能力承擔模型推論所需的基礎設施。
更直接的例子是 GMI 與 MiniMax 的合作公告,公告說明 MiniMax M2 與 Hailuo 2.3 在 GMI 的推論引擎原生執行,M2 也支援 SGLang 推論優化。
對這類服務,GMI 面對的是自己部署與營運模型的成本,售價可以依硬體、利用率、工程效率與商業條件制定,從部署模式推論,它有機會用不同成本結構提供較低牌價。
這份公告的證據範圍是所列模型,GPT、Gemini 與每一款影片模型的供應路徑,仍須看各自文件,不能因為 GMI 有 GPU 就認定整個目錄都在它的 GPU 上執行。
同一批 GPU 能處理更多工作,單位成本就能下降
GMI 公告支援 NVIDIA Dynamo,而 NVIDIA 的技術說明列出快取感知路由、資源規劃,以及把讀取提示的 prefill 與生成答案的 decode 分開調度。
白話來說,重複的上下文可以減少重算,不同階段可以安排到合適的資源,資源也能隨負載調整,這些機制能提高同一批硬體的有效產出。
可以用一個簡化例子理解,假設同樣一小時的硬體與營運成本,從原本產出 100 萬個計費 tokens 變成 150 萬個,平均每 token 成本就降到原來的三分之二,這是成本原理的示意,並非 GMI 的實際財務數字。
因此推論優化是有技術依據的低成本途徑,但 GPU 效能提升倍數、個案 compute 成本下降幅度與客戶 API 折扣,分母各不相同,不能直接互換成「全部 API 便宜多少」。
合作促銷能把售價暫時壓得更低
GMI 與 MiniMax 的聯合活動曾在 2026 年 8 月 24 日到 9 月 6 日,提供 M3、M2.7 等指定模型 14 天免費使用,活動頁也明寫期間結束後恢復標準計價。
這能證明平台與模型商曾共同做市場推廣,但該頁沒有揭露免費額度由誰負擔,也不能用已結束的免費活動,解釋每一個現行模型折扣的出資方式。
模型商想擴大使用量、平台想吸引開發者,都是合理的商業動機,文章能據此解釋促銷邏輯,但真正公開可確認的是活動範圍與期限。
官方零售價與平台取得成本,本來就可能不同
Google 的官方價目列有企業用量折扣,GMI 定價文件也列有企業合約與承諾用量方案,這些公開資訊支持「牌價之外存在商務議價」這件事。
但它們沒有公布 GMI 對 OpenAI、Google 或其他閉源供應商的實際合約,所以「GMI 一定拿到某個批發折數」仍是未被證明的說法,不能拿來填補每個低價模型的原因。
我對現有證據的判斷是,原生部署與推論優化有公開資料支持,合作促銷有實際案例,特定模型的採購折扣與補貼比例需要合約或公司揭露才能確認。
首儲贈額能省多少?把算法也算對
GMI 報價畫面的首儲優惠是「儲值 50 美元,加贈 3 美元」,等於付出 50 美元取得 53 美元的可用額度,假設贈額與儲值額度都能完整用完、適用相同計費項目,有效成本係數是 50 ÷ 53,約為 94.34%。
所以它是「額外取得 6% 額度」,對同一筆按牌價計算的消費,有效成本降低約 5.66%,兩個百分比的分母不同。
如果原本模型就比官方便宜 30%,再把全部可用額度的首儲效果算進去,這筆儲值所能支付的對應用量,成本比例是 70% × 50 ÷ 53,約為官方的 66.04%,也就是約省 33.96%,不能直接相加成 36%。
首儲只作用在符合優惠的那筆額度,後續大額用量仍應以模型費率估算,這種小額贈額也無法抵銷 Gemini 3.6 Flash 的兩倍報價。
便宜會不會影響回答品質?
本文是價格與計費規則研究,尚未做官方與 GMI 的同題品質對照,不能據此確認兩邊回答品質相同,也不能把折扣當成品質測試的結果。
低價可以來自前面說明的部署效率與促銷,單看價格不足以證明模型被換掉,也不足以保證回答一樣好,這兩件事都需要另外查證。
先對齊版本、精度與推理設定
版本、精度與服務等級要一致:日期後綴、FP8、Highspeed、Preview、Fast 都可能代表不同部署或產品。
本文前面的價格表回答同名模型的報價差異,屬於費率與計費規則研究,正式串接時仍要核對精確 model ID、推理設定、上下文限制與工具支援,品質、延遲與實際扣款則需要另外實測。
比較時,把相同問題、文件與提示詞交給兩邊,先對齊精確 model ID(模型識別碼)、版本、部署精度、推理設定、上下文與工具支援,設定無法確認一致時,就先標成比較限制。
另一個常見漏項是模型的思考過程,OpenAI 的 reasoning 文件指出推理 tokens 計入輸出費用,Google Gemini 價目也把 thinking tokens 列入輸出,估算時應採 API 回傳的計費用量,單靠最後看見的回答長度會低估成本。
哪些模型不適合硬塞進同版本折扣表?
完整研究需要保留比較邊界,目錄出現模型名稱,只代表平台列有該項目,版本、精度或計費單位對不上時,硬算百分比會讓表格變得漂亮,卻失去採購意義。
這張表可以看到,版本、精度或影片規格對不上時,價格差不能直接當成同一款 AI 的折扣。
| 項目 | 比較時遇到的問題 | 正確處理 |
|---|---|---|
| 舊 DeepSeek V4 Flash、Vision Exp | 官方已退役,舊名稱請求轉由 V4.1 Flash 服務 | 依實際底層版本比價 |
| 無日期的 DeepSeek-V4-Pro | GMI 樣本另有不同報價,不能自動等同 0813 版 | 保留日期後綴,分開處理 |
| FP8、FP4 模型 | 推論精度可能與另一平台部署不同 | 同時比較部署設定與任務品質 |
| Gemma、GPT-OSS 等開放權重模型 | 權重取得與代管推論是不同成本項目 | 比較其他代管價或自行部署成本 |
| Hailuo、Kling、Seedance 等影片 | Request 標價不足以涵蓋長度、解析度、音訊與模式 | 先取得同規格完整計價 |
| 價格欄位為空或 Free 的項目 | 缺少正常付費費率或優惠條件 | 查明可用性、額度與期限再納入 |
例如 DeepSeek 官方已明列舊 Flash 模型退役後的名稱轉接規則,拿 GMI 保留的舊版本牌價,直接對照官方新版本的價格,最後會同時混入「換模型」與「換供應商」兩種差異。
用真實工作測品質,再算合格結果成本
如果主要使用 GLM-5.3-Flash、GLM-5、GLM-5.3 或 MiniMax-M2.7、M3,GMI 報價已提供具體的成本理由,接下來應用同一組真實任務比較品質、延遲、快取命中與計費用量,確認折扣能否落到實際帳單。
先訂出合格標準,再記錄有沒有答錯、漏掉重點、工具呼叫失敗或需要重做,同時記錄延遲、API 回傳的計費用量與人工修改時間,最後比較每件完成且合格的工作花多少錢,本文目前還沒有這組實測結果。
成本還要看「一個完成且合格的任務花多少錢」,假設平台 A 每次生成 0.70 美元、合格率 50%,平台 B 每次 1 美元、合格率 80%,用這組示意數字估算,平均每份合格結果分別是 1.40 與 1.25 美元,重做與人工修正會改變原本的單價優勢。
採購前,也要核對工作流程與管理工時
如果主要使用 GPT、Gemini 或 Grok,而同名基本報價一樣,我會把平台價值放在整合便利性與管理工時,GMI MaaS 頁面列有多模型整合與集中帳務,這些功能可以減少營運負擔,但需要另外估算,不能當成 token 單價已降低的證據。
如果工作可以排程,優先比較官方 Batch 與 DeepSeek 離峰價,如果需要 Veo Fast 的 720p 含音訊影片,本文列示的 Google 報價更省,如果使用 Gemini 3.6 Flash,就要把 Google 的有效優惠納入計算。
我該怎麼選
如果你已經在用 GLM 或 MiniMax,我會先確認你使用的版本有沒有折扣,再挑一小部分真實工作測試。回答符合需求,實際帳單也比較低,再增加用量。
如果你主要使用 GPT 或 Gemini,而且工作可以晚點拿到答案,先比較官方的整批處理方案。使用 DeepSeek,就把執行時段算進去,能排到離峰的工作,依本文比較,官方價格更低。
同價時,選 GMI 的理由可以是把多種 AI 集中在一個平台,少處理幾套串接與帳務。這個便利性值多少,要看它實際替你省下多少工作。
最後,把重做與人工修改一起算進成本。便宜的答案如果一直答錯,省下的 API 費用很快就會花在修改上。我的選法是先測最常做的工作,再決定在哪裡買,讓每件完成的工作真正變便宜。
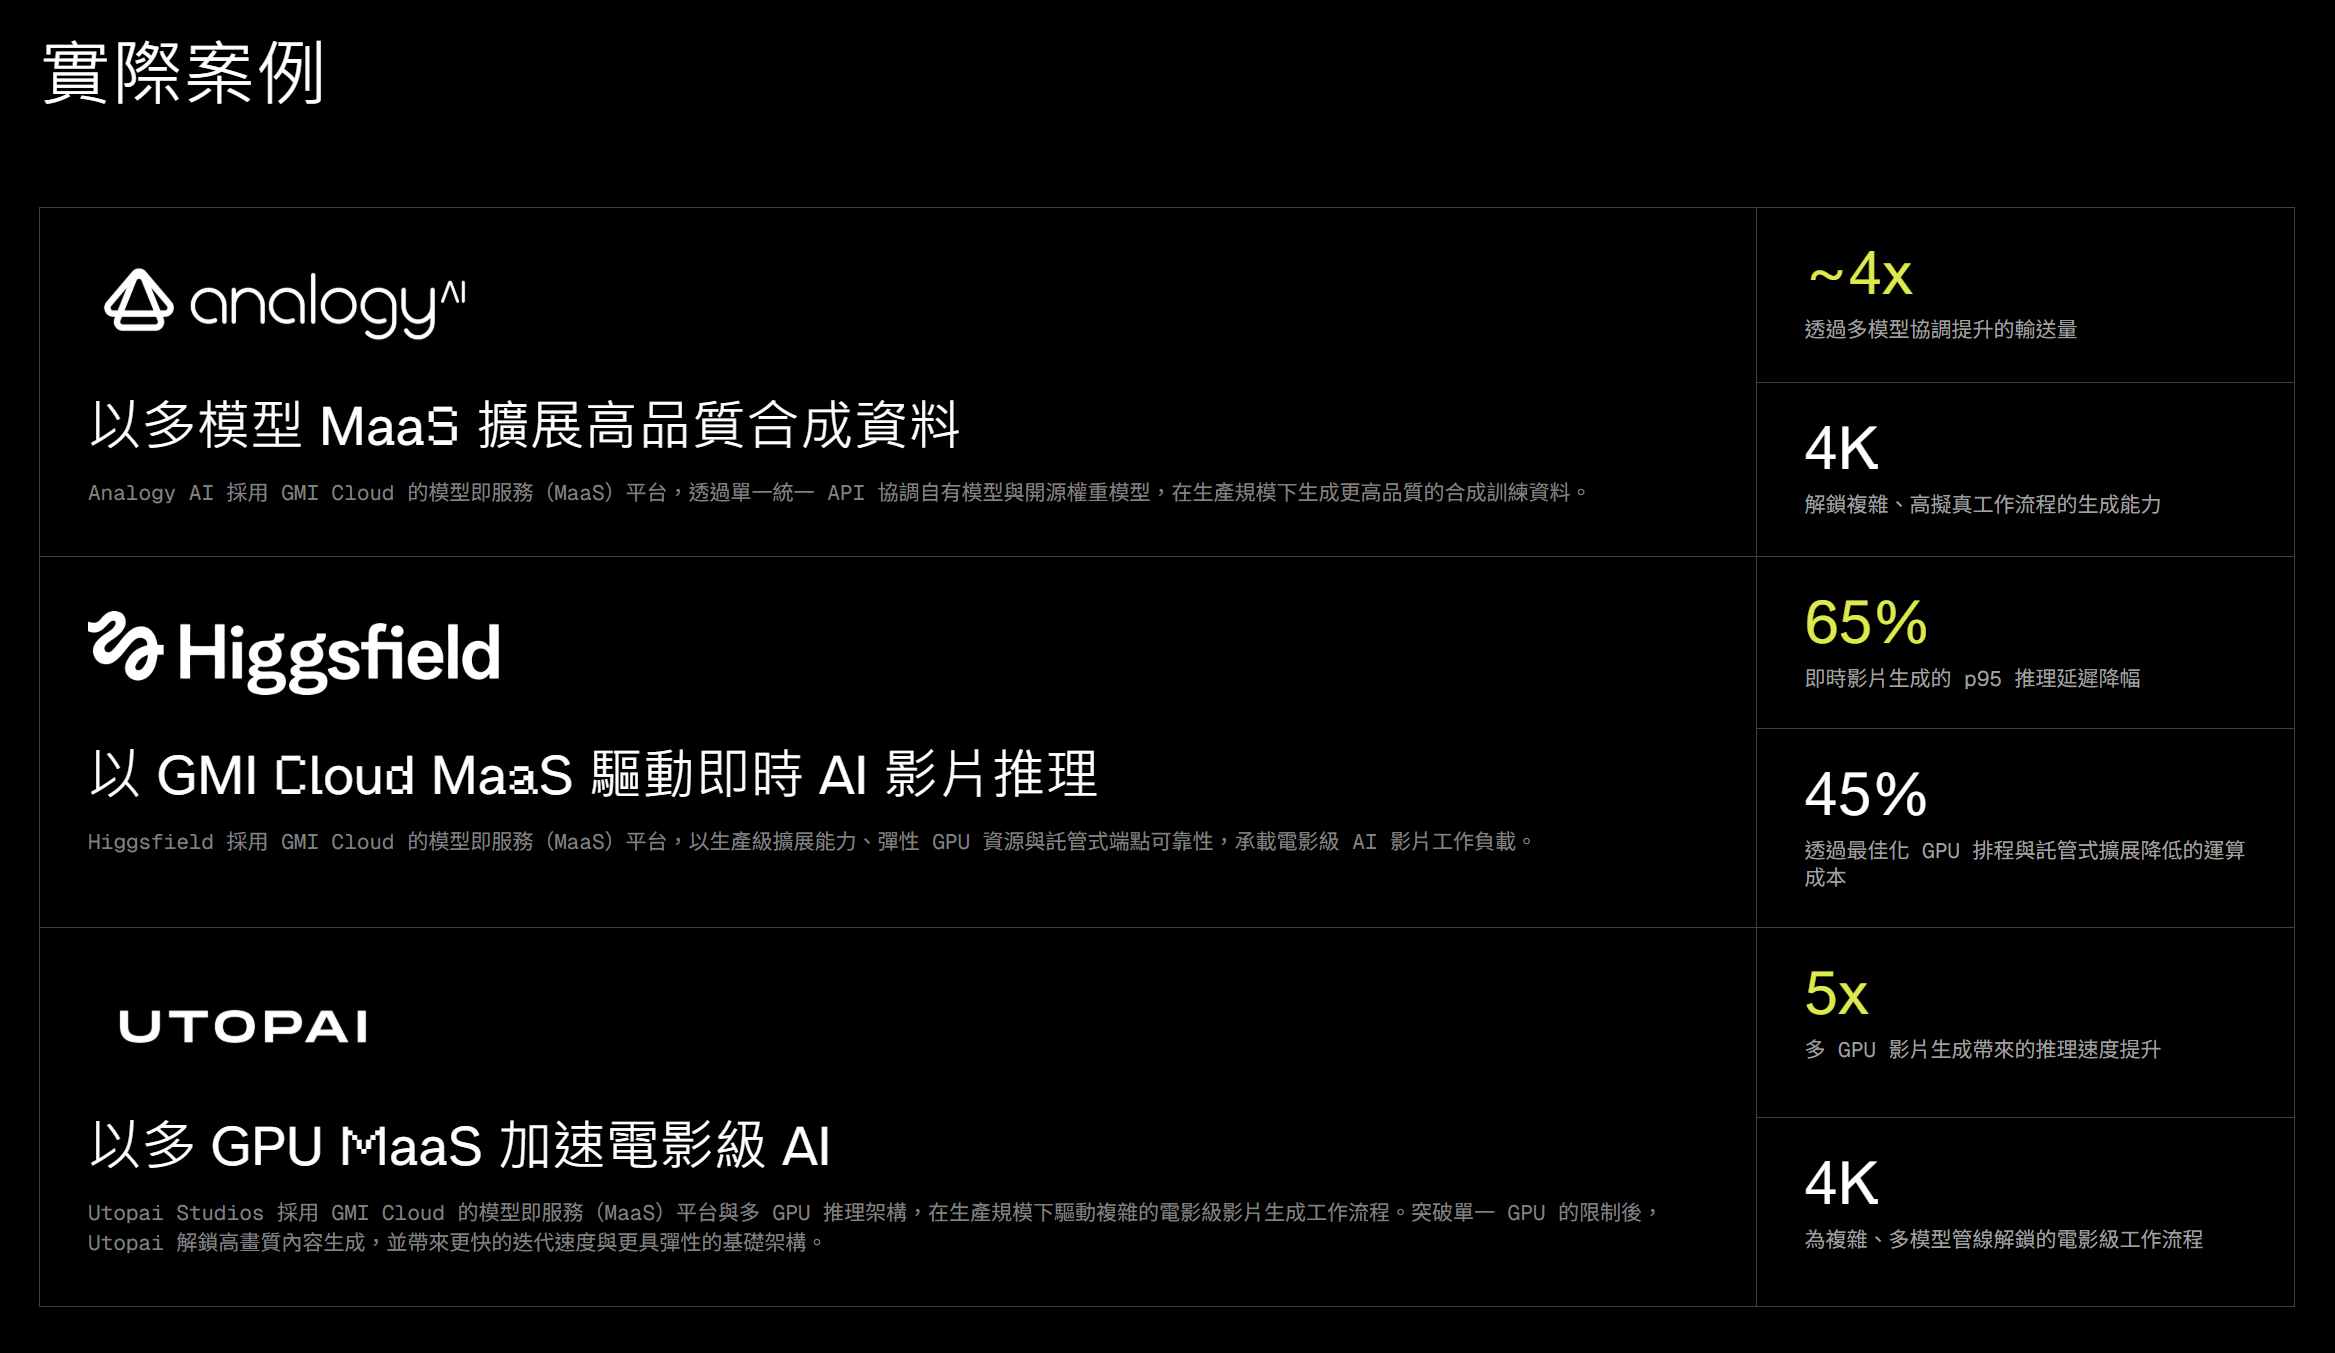
延伸閱讀
想進一步分清訂閱方案與 API 用量的價值,可以閱讀科技翰林院的〈ChatGPT Pro 跟 Claude Max 訂閱 200 美元超划算?價值上萬美元?〉。
對 AI 基礎設施與模型導入產品的關係有興趣,也可以閱讀〈NVIDIA、OpenAI、Dify 台北同台,GMI Cloud 談模型如何真正走進產品〉。
參考資料
- GMI 定價說明與 Model Hub
- Z.AI 官方 API 價格
- MiniMax 官方隨用隨付價格
- OpenAI 官方 API 價格
- GPT-6.1 Sol 模型與長上下文定價
- Google Gemini API 官方價格
- Grok 4.6 官方價格與規格
- DeepSeek 官方模型版本、價格與時段
- Google Cloud 影片模型價格
- GMI Veo 3.1 Standard 文件
- GMI Veo 3.1 Fast 文件
- GMI Veo 3.1 Lite 文件
- GMI 與 MiniMax 原生部署合作公告
- GMI 的 NVIDIA Dynamo 合作公告
- NVIDIA Dynamo 技術說明
- GMI 與 MiniMax 聯合優惠活動
- OpenAI Batch API
- Google Gemini Batch API
- OpenAI Prompt Caching
- OpenAI Reasoning Models
- Google Cloud Veo 3.1 模型版本
- Google Cloud 模型端點與地區
- GMI 公司與基礎設施介紹
- GMI MaaS 服務說明
GMI 文字模型費率採 Model Hub 報價樣本,影片則採上述 GMI 模型文件,官方欄位採相應供應商的公開 API 價目,實際購買時應以符合所選模型、規格、區域及服務等級的帳號報價為準。
常見問題 FAQ
GMI Cloud API 是否真的比官方便宜?
部分模型確實較便宜,在本文 20 款文字模型的同名報價比較中,採一般標準費率與 DeepSeek 尖峰價時,GMI 有 7 款較便宜、12 款同價、1 款較貴,DeepSeek 改採官方離峰價後,兩款 DeepSeek 都會變成官方較省。
哪些 GMI 模型的折扣最明確?
本文樣本中的 GLM-5.3-Flash 與 GLM-5,相對官方輸入、輸出及快取讀取費率便宜 40%,GLM-5.3 約便宜 30%,MiniMax-M2.7 便宜 30%,M3 在本文採用的輸入範圍便宜 20%。
GMI 為什麼能比模型原廠賣得便宜?
公開資料顯示部分 MiniMax 模型在 GMI 推論引擎原生執行,GMI 也公開支援 NVIDIA Dynamo 與聯合促銷,這些機制提供不同成本結構與短期優惠的空間,個別閉源模型的採購價與補貼比例仍需供應商揭露。
使用 GMI DeepSeek 一定比較省嗎?
要看時段,V4.1-Flash 相對官方尖峰價便宜 40%,相對離峰價卻貴 20%,Pro-0813 相對尖峰便宜 20%,相對離峰貴 60%,能在晚上或週末執行的工作,官方離峰費率更有價格優勢。
GMI 的 GPT 與 Gemini 都比較便宜嗎?
本文列出的三款 GPT 短上下文 Standard 報價與官方相同,Gemini 多數同價,3.6 Flash 的 GMI 樣本價高於 Google 有效優惠價,能等待的工作還應比較官方 Batch。
GMI Veo 3.1 Fast 的 0.15 美元是一整支影片的價格嗎?
GMI 模型文件寫的是每秒 0.15 美元,8 秒的費率試算為 1.20 美元,在 720p、含音訊條件下,Google 每秒 0.10 美元,8 秒為 0.80 美元。
便宜的 API 是否代表模型被偷換或品質較差?
本文尚未進行官方與 GMI 的同題品質對照,目前不能確認兩邊回答品質相同。低價本身不足以證明模型被替換,比較時應核對精確 model ID、版本、部署精度、推理設定與工具支援,最有用的驗證是把相同真實任務交給兩邊,比較合格結果、延遲與計費用量。
儲值 50 美元送 3 美元,是否等於再便宜 6%?
它代表額外取得 6% 額度,如果 53 美元可用額度全部用完,對同一筆牌價消費的有效成本降低約 5.66%,而且適用範圍是該筆優惠額度。