NotebookLM 可以抓無字幕 YouTube 逐字稿嗎?實測免費匯出
YouTube 影片沒有字幕,NotebookLM 還能抓中文逐字稿嗎?
Google 官方說明寫得很明確,Gemini Notebook 僅支援「含有字幕(使用者上傳或自動生成)」的公開 YouTube 影片。這裡最容易誤解的地方,是 YouTube 播放器前台看不到 CC 按鈕,不代表影片一定沒有自動生成字幕。
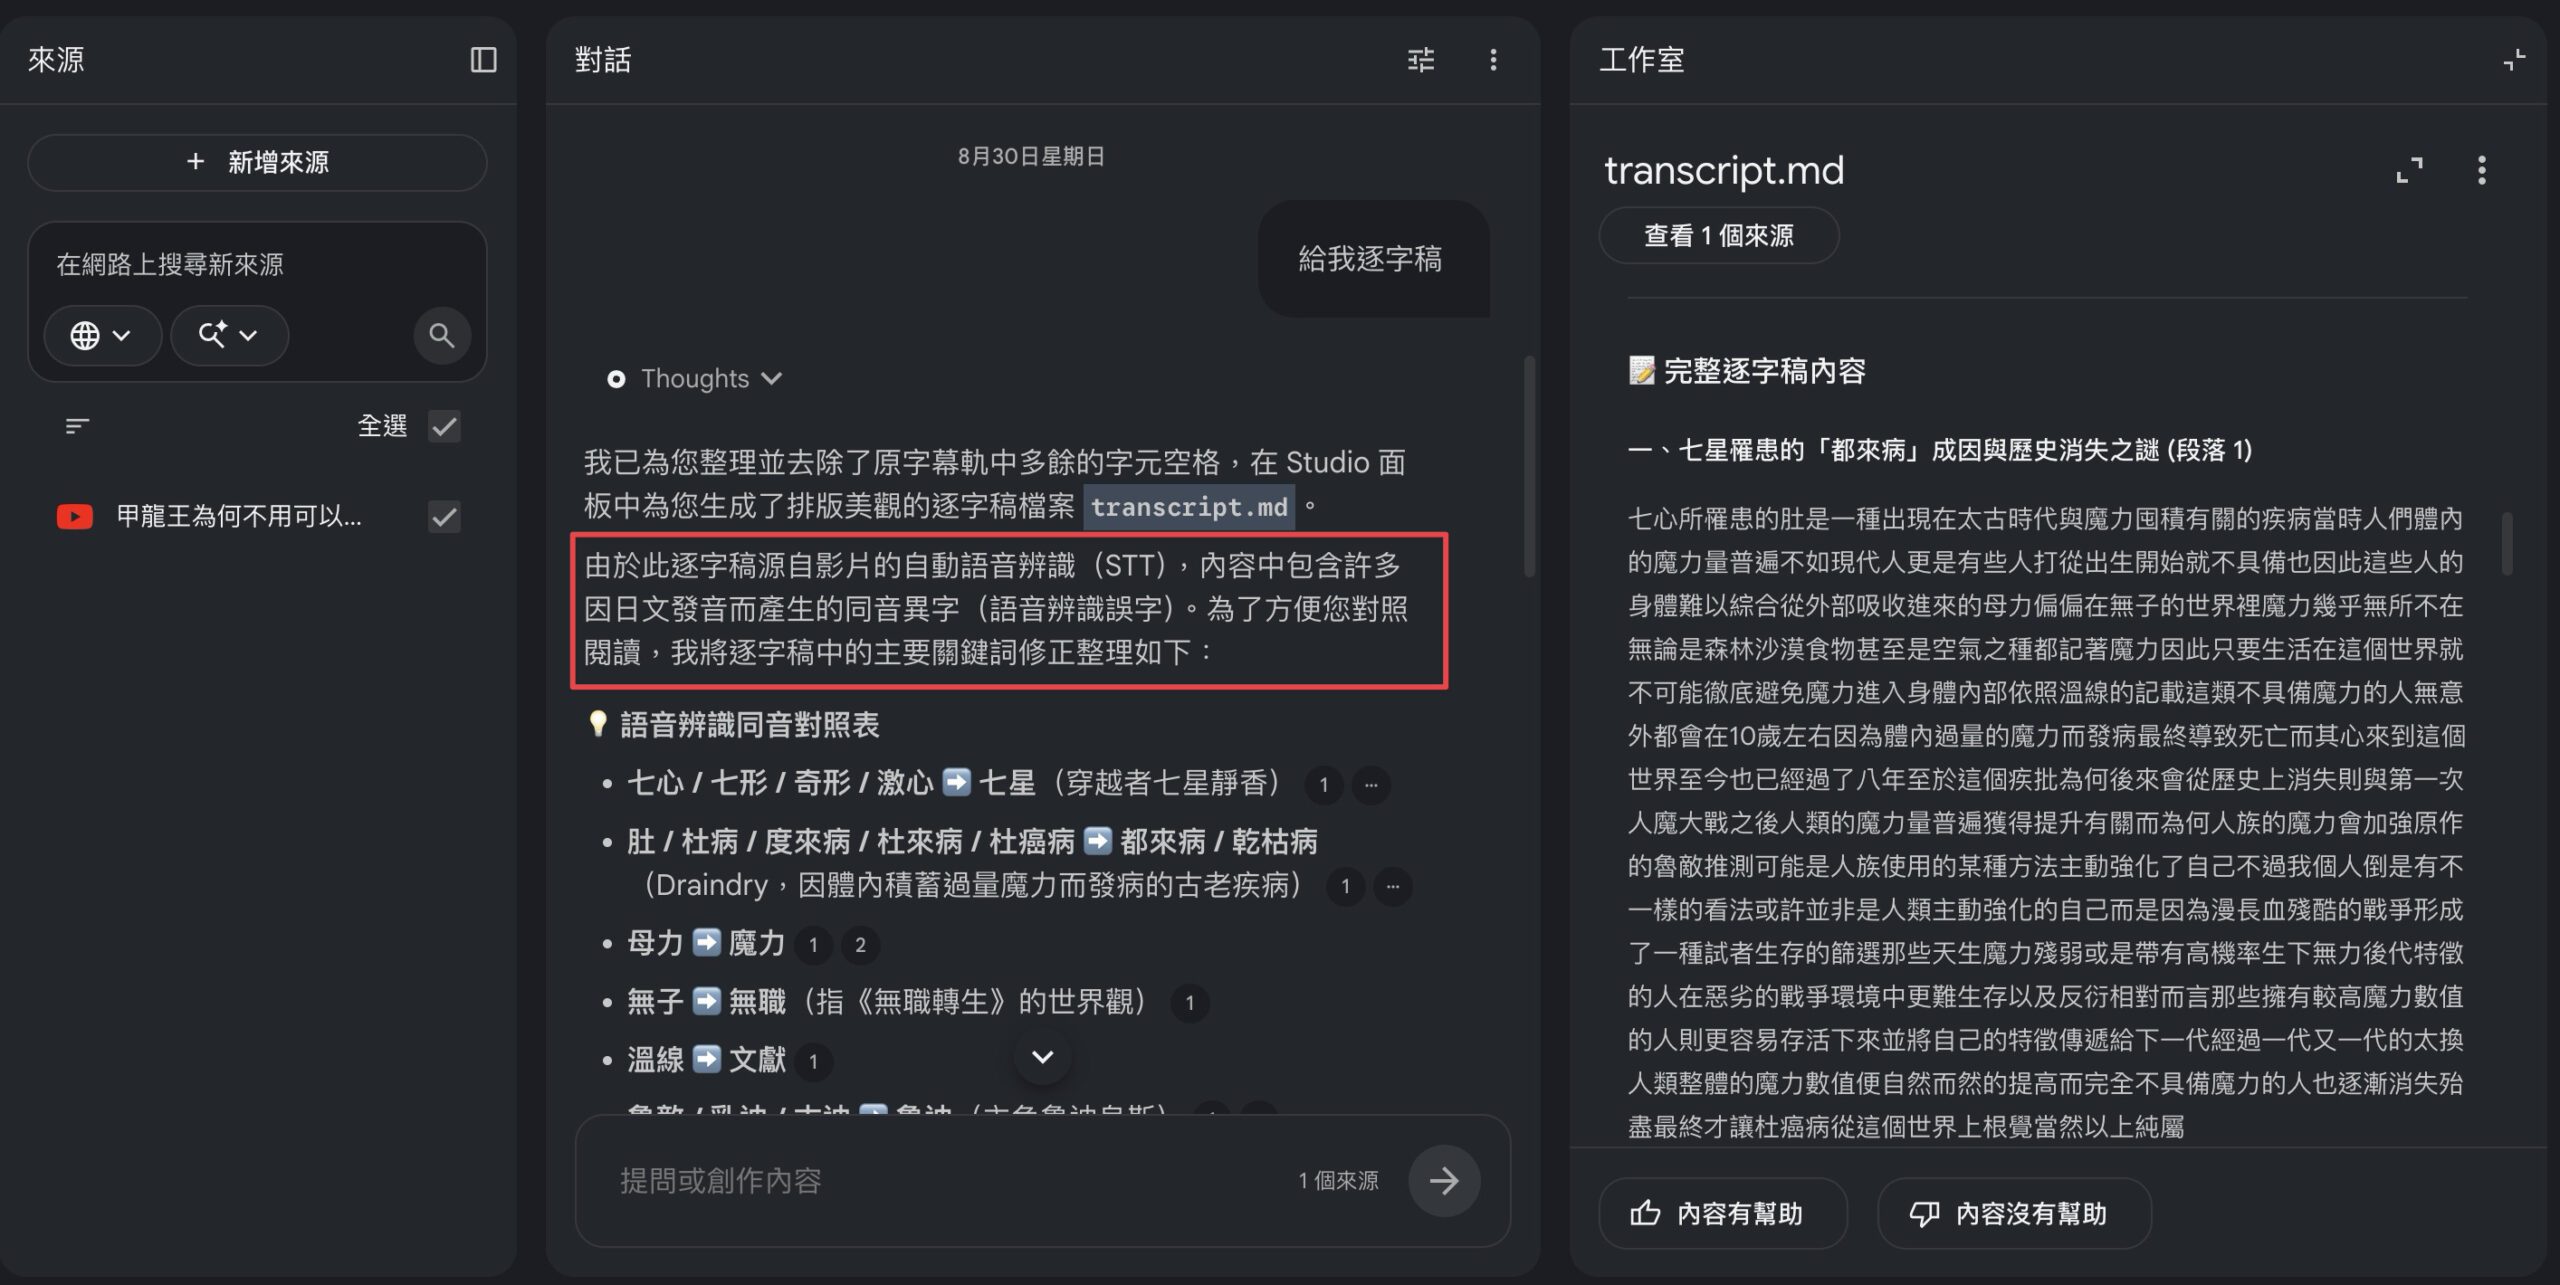
我把一支前台沒有可見字幕的公開影片加入 NotebookLM,來源成功完成處理,也生成了完整的 transcript.md。畫面顯示「此逐字稿源自影片的自動語音辨識(STT)」,但這句話只能證明文字源自語音辨識,無法單獨判定是 YouTube 的自動字幕,還是 Gemini Notebook 另外執行的語音辨識。
所以這次實測能證明的是「沒有可見字幕,仍可能成功匯入」,不能進一步宣稱 Gemini Notebook 一定會直接對影片執行語音辨識。NotebookLM 已於 2026 年 7 月更名為 Gemini Notebook,本文為保留既有搜尋習慣,兩個名稱會交替使用。
實測結果:沒有可見字幕,NotebookLM 仍成功產生逐字稿
這次測試使用的是 RIVER 遊戲頻道的公開 YouTube 影片,片長 14 分 31 秒,影片頁面沒有可見字幕。我直接把網址加入 NotebookLM,來源完成處理後,再請它建立逐字稿文件,最後得到完整的 Markdown 內容。
- NotebookLM 成功加入 YouTube 影片來源。
- 工作室成功生成
transcript.md。 - 畫面標示逐字稿來自自動語音辨識(STT),但沒有標示語音辨識由哪一個服務執行。
- 逐字稿包含日文譯名造成的同音異字,這是自動語音辨識常見的錯字特徵,不能用來判斷是哪個服務產生逐字稿。
- 抽查逐字稿開頭與結尾,內容沒有被截斷。
因此實務上不要只看 YouTube 播放器有沒有顯示 CC 按鈕。想先檢查公開字幕軌,可以執行 yt-dlp --list-subs "影片網址",看到 automatic captions 就代表 YouTube 有自動字幕。即使查不到公開字幕軌,也可以先交給 NotebookLM 嘗試,明確匯入失敗後,再考慮 Whisper 或其他替代路徑。
為什麼這條路比較快
一般雲端轉錄流程,通常要先下載影片或抽出音訊,再把檔案上傳給語音模型,等待模型辨識後才能匯出。
NotebookLM 的差別,是可以直接從公開 YouTube 網址建立來源,省掉本機下載與重新上傳。
一般轉錄流程
- 下載影片或音訊。
- 必要時轉換檔案格式。
- 上傳到雲端語音辨識服務。
- 等待轉錄。
- 匯出逐字稿。
NotebookLM 流程
- 貼上公開 YouTube 網址。
- 等待 NotebookLM 完成來源處理。
- 匯出完整逐字稿。
如果直接搬移一支 500MB 影片,網路下載速度是 100Mbps、上傳速度是 20Mbps,理論下載約 40 秒、上傳約 200 秒,合計接近 4 分鐘。不過 Whisper 實務上通常會先用 yt-dlp -f bestaudio 抽取音訊,不需要下載與上傳完整影片。以 23 分鐘內容約 20MB 的簡化情境估算,下載加上傳通常不到 30 秒,實際時間仍會受音訊格式、網路速度與服務排隊影響。
因此 Gemini Notebook 的主要優勢不是固定省下 4 分鐘,而是少做抽取音訊、上傳檔案與管理另一套轉錄服務。這只是簡化的情境估算,不是每個人的固定速度。
不用 Gemini API,現有免費額度內新增成本是 0 元
這條流程不需要申請 Gemini API Key,也沒有另外呼叫 Gemini API。
以這次實測來說,在 NotebookLM 現有免費額度內,新增成本是 0 元。
如果改走 OpenAI Whisper API,官方價格是每分鐘 0.006 美元,30 分鐘約 0.18 美元。本機 Whisper 沒有 API 費,但會消耗自己的電腦運算與等待時間。Whisper 的費用其實不高,NotebookLM 真正的優勢仍是省掉下載、上傳與另外管理 API 的步驟。
要注意的是,「這次新增成本是 0 元」不等於永久免費或無限制。NotebookLM 免費版有來源數量與功能額度,Google 也可能調整規則。
GitHub 上四個相關專案,定位與維護量級差很多
我接著比較 GitHub 上幾個名稱很像的專案,差別不在於能不能輸出文字,而在於逐字稿究竟是從 NotebookLM 匯出,還是先用其他工具抓字幕。
teng-lin/notebooklm-py
這次採用的方案,它會直接操作 NotebookLM,把 YouTube 網址加入來源,等來源完成處理後,再用 source fulltext 取回完整文字,不依賴 yt-dlp 或 youtube-transcript-api 擷取字幕。查核時約有 1.9 萬顆 GitHub 星星,是四個專案中規模與維護活動明顯最高的核心工具。
curara81/notebooklm-toolkit
這是建構在 notebooklm-py 之上的衍生工具,適合批次匯入,但逐字稿功能實際使用 yt-dlp 下載人工或自動字幕,並不是從 NotebookLM 取回 fulltext。它的 README 仍指定 notebooklm-py v0.3.x,查核時只有 2 顆星、1 個 commit,而核心套件已更新到 0.8.x,導入前要先自行確認相容性,不宜把它視為與核心套件同量級的平行選項。
akshayonly/youtube-to-notebooklm
使用 youtube-transcript-api 擷取字幕,再整理成適合交給 NotebookLM 的文字檔。它是替 NotebookLM 準備字幕,不是透過 NotebookLM 產生逐字稿。
FrancescoLavelli/Notebooklm-Youtube-Transcript-Extractor
同樣使用 youtube-transcript-api 擷取字幕,屬於 NotebookLM 的前處理工具。查核時為 0 顆星、3 個 commits,適合參考簡單實作,不建議把它當成持續維護的完整方案。
所以最後我選擇 notebooklm-py,因為它符合我要的完整路徑:讓 AI Agent 直接把 YouTube 加入 NotebookLM,再把 NotebookLM 已處理的文字匯出。想進一步理解 Skill、MCP 與 API 的角色差異,可以閱讀《Skill、MCP、API 是什麼?三者差別與三層架構一次看懂》。
把它做成 AI Agent 可以重複執行的 Skill
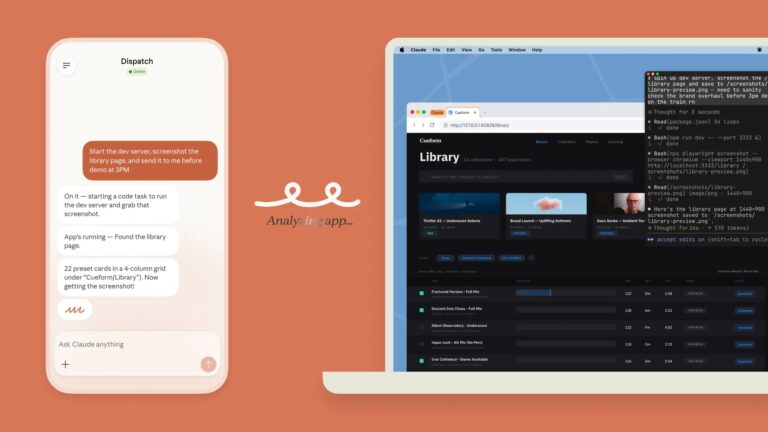
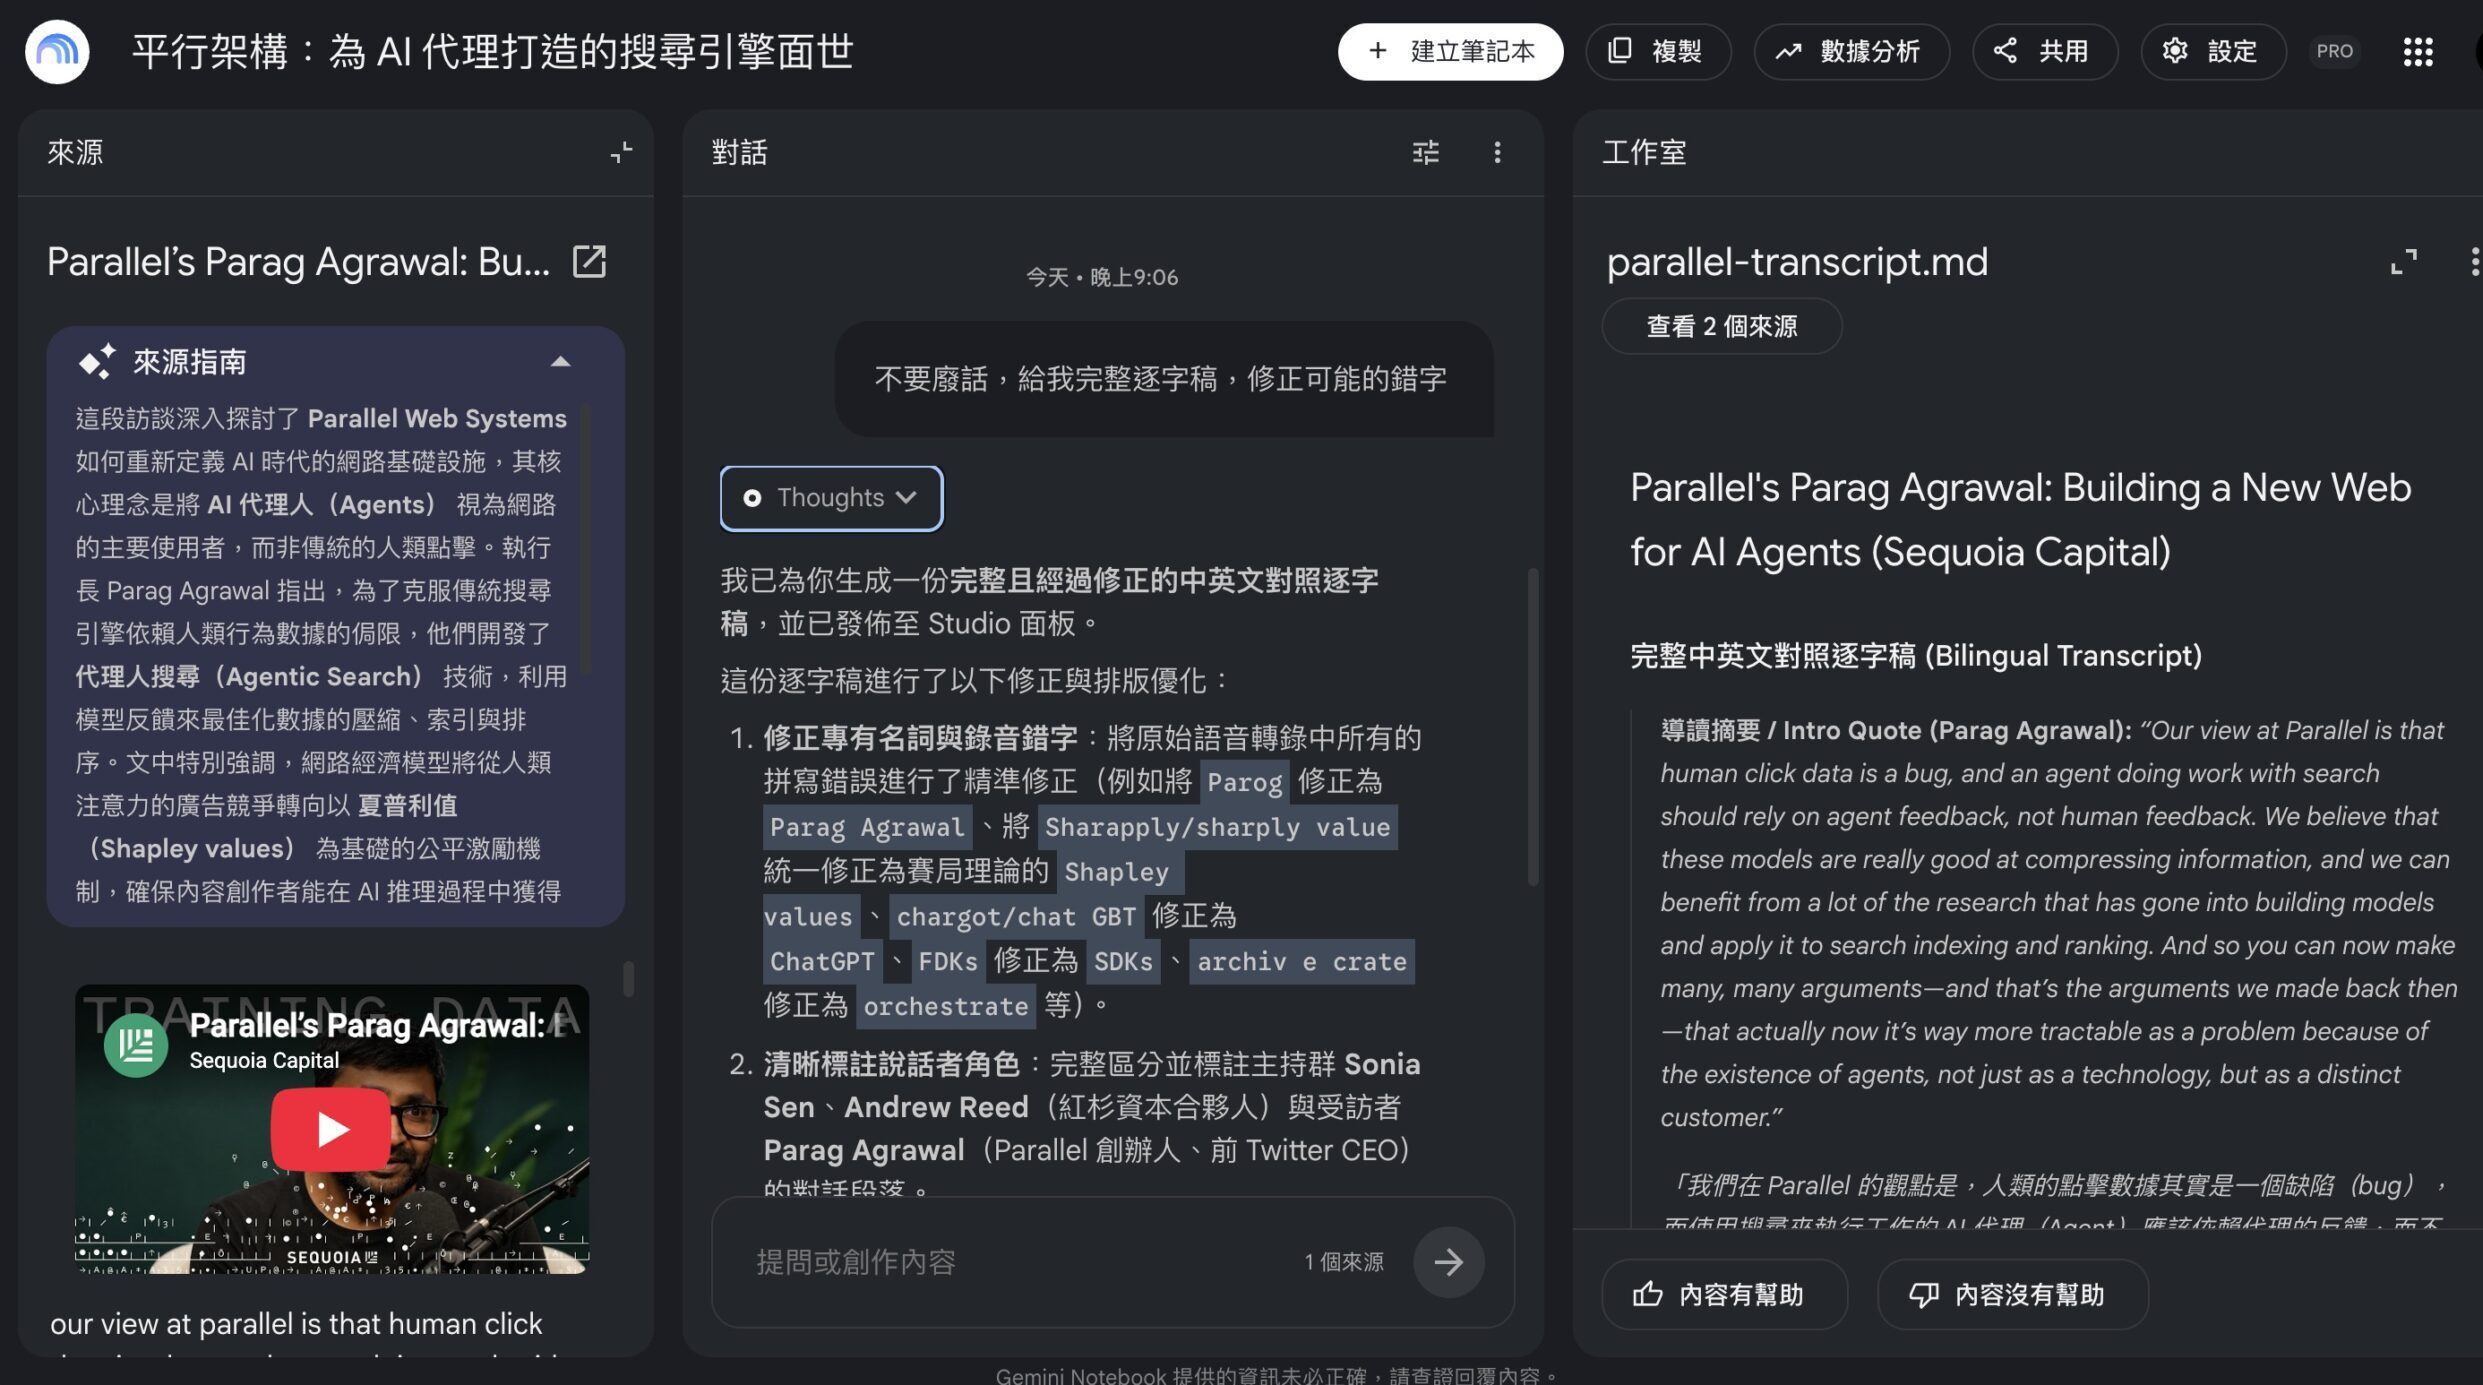
手動在 NotebookLM 貼網址已經很省事,但如果經常處理影片,還可以把流程交給 AI Agent。安裝開源 Skill 後,Agent 能建立筆記本、加入影片、等待來源處理、匯出 Markdown,再檢查逐字稿開頭與結尾。
npx skills add teng-lin/notebooklm-py之後只要貼上 YouTube 網址,給 Agent 一句指令:
用 NotebookLM 抓完整逐字稿。
這就是 AI 分身從聊天走向實際交付工作的具體例子,不是只請模型回答問題,而是讓它照固定流程操作工具、保存成果並驗證結果。
官方規則怎麼讀,這次實測又能證明什麼
Google 官方說明目前寫的是,僅支援含有字幕「使用者上傳或自動生成」的公開 YouTube 影片。YouTube 自動字幕本來就是語音辨識產物,所以看到 STT 字樣,不能直接推論 Gemini Notebook 另外對影片跑了一次語音辨識。
另一方面,我在 2026 年 9 月 5 日對這支測試影片執行 yt-dlp --list-subs,工具回報沒有公開自動字幕或字幕軌,youtube-transcript-api 也回報字幕已停用。這代表公開工具目前抓不到字幕,但仍不能證明 Google 內部是否存在未公開的自動字幕軌,也不能證明 Gemini Notebook 一定自行執行 STT。
最準確的結論是,官方文件的文字本身沒有漏掉自動字幕,這次實驗則無法確定逐字稿究竟來自 YouTube 內部字幕,還是 Gemini Notebook 的其他處理流程。前台沒有 CC、公開工具查不到字幕,以及 NotebookLM 能匯入,三件事都應分開陳述。
對使用者來說,正確策略很簡單:不論有沒有字幕,都先試 NotebookLM,失敗再切換替代方案。
- 影片必須能被 NotebookLM 存取,私人影片、年齡限制或區域限制可能失敗。
- 上傳時間在 72 小時內的影片可能無法匯入。
- 自動語音辨識仍會出現人名、專有名詞與同音異字錯誤,正式使用前要校對。
notebooklm-py是社群開源專案,不是 Google 官方 API,Google 改版後可能需要更新。- 免費版每個筆記本最多可加入 50 個來源,每個來源最多 50 萬字,YouTube 影片長度不受限制,但字幕檔案不得超過 50 萬字,額度與規則仍可能調整。
最後的總結
NotebookLM 抓 YouTube 逐字稿的價值,不只是少付幾毛錢,而是把一開始就不需要做的步驟刪掉。
以前先下載影片、抽音訊、上傳、再等待模型轉錄,現在可以先貼網址,讓 NotebookLM 直接處理。
這次實測能證明的是,沒有可見字幕不等於不能處理,不能據此判定逐字稿一定由 Gemini Notebook 自行進行 STT。
我的固定工作流因此改成:公開 YouTube 一律先交給 NotebookLM,成功就匯出 fulltext 並抽查開頭與結尾,只有 NotebookLM 明確失敗,才改用本機 Whisper。
推薦閱讀
- 真正的 AI 分身怎麼做?從聊天到交付工作!四個零件讓 AI 替你工作
- 我已經會 Claude 還需要學 Hermes Agent 嗎?v0.20 改版功能
- Skill、MCP、API 是什麼?三者差別與三層架構一次看懂
參考資料
- Google:在 Gemini Notebook 加入來源
- Google:NotebookLM 使用限制
- Google:NotebookLM 更名為 Gemini Notebook
- teng-lin/notebooklm-py
- 本次測試的 YouTube 影片
- OpenAI Whisper API 官方價格
常見問題 FAQ
NotebookLM 可以抓沒有可見字幕的 YouTube 影片嗎?
有可能。YouTube 前台沒有顯示 CC,不代表一定沒有自動字幕,這次測試影片即使公開工具查不到字幕軌,NotebookLM 仍成功匯入。這項結果不能單獨證明 NotebookLM 自行執行 STT,最有效的做法仍是先直接嘗試,明確匯入失敗後再改用 Whisper。
這個流程需要 Gemini API Key 嗎?
不需要。影片來源處理由 NotebookLM 完成,開源 notebooklm-py 負責自動加入來源與匯出 fulltext,不必另外呼叫 Gemini API。
NotebookLM 抓逐字稿是完全免費嗎?
在現有免費額度內,這次實測新增成本是 0 元,但不能解讀成永久免費或無限制。免費版每個筆記本最多 50 個來源,每個來源最多 50 萬字,Google 也可能調整規則。
NotebookLM 和 Whisper 應該先用哪一個?
公開 YouTube 建議先用 NotebookLM,因為可以省掉抽取音訊、上傳與 API 管理。若影片因權限、區域、上架時間或服務限制而匯入失敗,再改用本機 Whisper。